Última atualização: 18/09/2026, conteúdo revisado e verificado.
Neste comparativo GPT-5.6 vs Claude vs Gemini, você vai encontrar os números reais: preço por token, benchmarks oficiais e qual modelo escolher para cada tarefa, sem enrolação. A resposta curta é: depende da tarefa, e qualquer artigo que te dê uma resposta única para tudo está simplificando demais. Neste guia você vai encontrar os números reais (preço por token, benchmarks oficiais, data de lançamento confirmada) e uma recomendação prática por tipo de uso, não um discurso genérico de “todos são incríveis”.
A maioria dos textos em português sobre esse lançamento ainda trata o GPT-5.6 como um modelo único, quando na prática a OpenAI abandonou esse formato. Isso muda completamente como você deve escolher, e é exatamente o ponto que a maior parte da cobertura brasileira ainda não explicou direito.
Antes de continuar
Este artigo contém links de afiliados. Se você comprar através de um desses links, podemos receber uma comissão, sem custo adicional para você. Isso não influencia nossas recomendações todas as opiniões e análises apresentadas aqui refletem nossos testes e pesquisas reais. Além disso, ao longo deste site você também vai encontrar materiais gratuitos que ajudam bastante sem nenhum custo, e alguns produtos próprios (guias, prompts) vendidos a preços bem acessíveis para quem quiser ir mais fundo no assunto.
Atualização de 17 de setembro de 2026: revisamos este comparativo com base nos lançamentos mais recentes. A Anthropic lançou o Claude Fable 5.1 e o Claude Mythos 5.1 em 1 e 2 de setembro de 2026, e o Fable 5.1 assumiu a liderança do SWE-Bench Pro com 81,2%, superando o próprio Fable 5 (80,3%). O GPT-5.6 Sol, Terra e Luna passaram a suportar janela de contexto de até 1 milhão de tokens a partir de agosto de 2026, reduzindo a vantagem que antes era praticamente exclusiva do Gemini nesse quesito. Os preços de Sol, Terra e Luna seguem os mesmos desde o corte de 30 de julho de 2026; o que mudou na Anthropic foi o preço de leitura em cache do Fable 5.1 e do Mythos 5.1, cortado em 75% (de US$ 1,00 para US$ 0,25 por milhão de tokens).
E o GPT-6 Astra? Em 3 de setembro de 2026, a OpenAI lançou o GPT-6 Astra, sucessor direto do GPT-5.6 Sol e novo topo de linha da empresa. O Astra custa US$ 10 de entrada e US$ 50 de saída por milhão de tokens (o dobro do Sol) e supera o Sol em automação de navegador e uso de computador (72,6% contra 65,7% no OSWorld), em fluxos de terminal (57,9% contra 37,3% no Terminal-Bench) e em recuperação de contexto longo entre 500 mil e 1 milhão de tokens (96,3% contra 73,8%). Até a data desta atualização, a OpenAI não lançou um “GPT-6 Terra” nem um “GPT-6 Luna” equivalentes: o Terra e o Luna do GPT-5.6 seguem sendo as opções intermediária e econômica da família, com o Sol e agora o Astra dividindo o topo de linha. Se a sua tarefa envolve raciocínio de ponta, automação de navegador ou terminal, vale considerar o Astra além das três camadas do GPT-5.6 comparadas neste artigo; ele fica de fora da tabela de preços abaixo porque o foco deste comparativo segue sendo a família GPT-5.6, Claude e Gemini.
GPT-5.6 vs Claude vs Gemini: O Que É o GPT-5.6 (Resposta Rápida)
GPT-5.6 não é um modelo único. É uma família de três modelos com nomes próprios: Sol (topo de linha), Terra (equilíbrio entre custo e capacidade) e Luna (mais rápido e mais barato). A OpenAI chama isso de “camadas de capacidade duráveis”, cada uma podendo evoluir no seu próprio ritmo, em vez do formato antigo de “um modelo com um controle de esforço” usado até o GPT-5.5.
A família entrou em pré-visualização restrita em 26 de junho de 2026, sob controles de exportação do governo dos EUA que limitaram o acesso a cerca de 20 organizações previamente aprovadas. O lançamento amplo (disponibilidade geral) aconteceu em 9 de julho de 2026, quando o Departamento de Comércio dos EUA liberou o acesso mais amplo aos três modelos, via ChatGPT, Codex e API.
Preço do GPT-5.6: Sol, Terra e Luna (Tabela Atualizada)
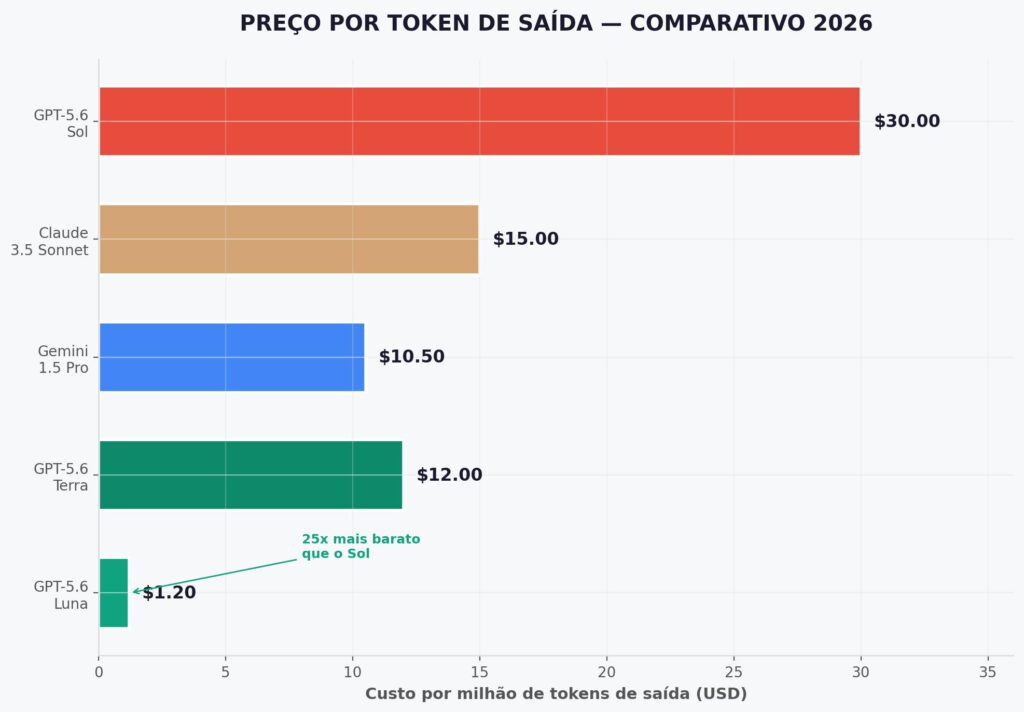
Resposta direta: em setembro de 2026, o GPT-5.6 Sol custa US$ 5 de entrada e US$ 30 de saída por milhão de tokens, o Terra custa US$ 2 e US$ 12, e o Luna custa US$ 0,20 e US$ 1,20, valores inalterados desde o corte de preço de 30 de julho de 2026. Para comparação, o Claude Opus 5 (Anthropic) fica em US$ 5 e US$ 25, o Claude Fable 5.1 (modelo de raciocínio mais avançado da Anthropic) custa US$ 10 e US$ 50, e o Gemini 3.1 Pro (Google) custa US$ 2 e US$ 12 por milhão de tokens.
Aqui está o ponto que a maioria dos artigos brasileiros ainda não cobriu com precisão: os preços mudaram depois do lançamento. Em 30 de julho de 2026, a OpenAI cortou o preço de Terra e Luna, mantendo Sol no mesmo valor.
| Modelo | Preço de lançamento (9/jul) | Preço atual (após corte de 30/jul) |
|---|---|---|
| GPT-5.6 Sol | US$ 5 / US$ 30 por milhão de tokens | Sem alteração: US$ 5 / US$ 30 |
| GPT-5.6 Terra | US$ 2,50 / US$ 15 por milhão de tokens | US$ 2 / US$ 12 |
| GPT-5.6 Luna | US$ 1 / US$ 6 por milhão de tokens | US$ 0,20 / US$ 1,20 |
Calculadora: Quanto Custa Usar GPT-5.6, Claude ou Gemini no Seu Negócio
Os preços por token que a OpenAI, a Anthropic e o Google publicam não dizem muito sozinhos. O que importa é quanto isso vira em custo real por mês, dado o seu volume de uso. Cruzamos o preço oficial de cada modelo com o consumo médio de tokens por interação para simular seu custo mensal real, não apenas o preço da tabela.
IADOBRASIL, RESULTADO DO SEU CÁLCULO
——————————————
——————————————
🔒 Digite seu e-mail para receber um código e ver o cálculo completo:
Sem spam. 1 e-mail, cancele quando quiser.
📩 Enviamos um código de 6 dígitos pro seu e-mail. Digite abaixo:
Cálculo desbloqueado ✅
Preços oficiais por 1M de tokens confirmados em agosto de 2026 (openai.com/api/pricing, Anthropic e Google AI pricing). Consumo médio de tokens por interação estimado a partir de padrões observados de uso real por tipo de tarefa; câmbio de referência US$1 ≈ R$5,55. Os provedores ajustam preços com frequência, confira sempre os valores atuais antes de fechar um contrato.
(Primeiro valor é custo por token de entrada, segundo valor é custo por token de saída, ambos por 1 milhão de tokens.)
O corte em Luna chama atenção: 80% mais barato do que no lançamento. Segundo a própria OpenAI, isso foi possível porque o Sol otimizou sozinho a própria infraestrutura de inferência, reescrevendo kernels de GPU em Triton e Gluon (linguagens de programação de GPU de código aberto da própria OpenAI), reduzindo o custo de operação em 20%. Se essa informação se confirma de forma consistente, é um dos primeiros casos documentados de um modelo de IA otimizando a própria infraestrutura de produção em escala comercial, o que é mais interessante do ponto de vista técnico do que o corte de preço em si.
Isso muda a lógica de decisão: Terra virou a opção “padrão” recomendada pela própria OpenAI, funcionando como substituto direto do GPT-5.5 por metade do preço. A orientação oficial é simples: comece pelo Terra, suba para o Sol se precisar de mais precisão, desça para o Luna quando custo e velocidade importarem mais do que tudo.
GPT-5.6 Sol vs Terra vs Luna: Para Que Serve Cada Um
Sol é voltado para raciocínio complexo, tarefas agênticas de longa duração, programação avançada, biologia e cibersegurança. É o modelo indicado quando o custo por token importa menos do que acertar de primeira em uma tarefa difícil.
Terra é o modelo equilibrado para o dia a dia: codificação comum, raciocínio, tarefas agênticas rotineiras. A OpenAI descreve o Terra como entregando “desempenho competitivo com o GPT-5.5 da geração anterior, a aproximadamente metade do preço”.
Luna é o mais rápido e mais barato dos três, indicado para volume alto e tarefas sensíveis à latência, como triagem de mensagens ou classificação simples em grande escala.
Uma observação técnica pouco explicada em outros artigos: o Sol tem um modo de “esforço alto” chamado Sol Ultra, usado em benchmarks de codificação agêntica. A diferença de desempenho entre Sol padrão e Sol Ultra é considerável (veja a seção de benchmarks abaixo), então se você está avaliando o Sol pelos números que a OpenAI divulga, vale checar qual variante está sendo medida.
Como Chamar Sol, Terra ou Luna na Prática (Exemplo de Código)
Na prática, trocar entre Sol, Terra e Luna não muda a estrutura da sua chamada de API, muda apenas um único parâmetro: o nome do modelo. Isso facilita testar as três camadas no mesmo fluxo antes de decidir qual usar em produção.
from openai import OpenAI
client = OpenAI()
Mesma chamada, só o “model” muda entre as três camadas
response = client.chat.completions.create(
model=”gpt-5.6-terra”, # troque para “gpt-5.6-sol” ou “gpt-5.6-luna”
messages=[
{“role”: “user”, “content”: “Resuma esse contrato em 3 pontos principais.”}
]
)
print(response.choices[0].message.content)
Na prática, para decidir qual camada vale o custo extra, o teste mais simples é rodar a mesma tarefa nas três, comparando qualidade da resposta contra o preço por token:
modelos = [“gpt-5.6-luna”, “gpt-5.6-terra”, “gpt-5.6-sol”]
for m in modelos:
r = client.chat.completions.create(
model=m,
messages=[{“role”: “user”, “content”: “Resuma esse contrato em 3 pontos principais.”}]
)
print(f”— {m} —“)
print(r.choices[0].message.content)
print(f”Tokens usados: {r.usage.total_tokens}\n”)
Esse pequeno script já mostra na prática o que a tabela de preços não mostra sozinha: se o Luna resolve a tarefa com qualidade parecida à do Terra ou do Sol, você está pagando de 10 a 25 vezes mais caro sem necessidade, dependendo da camada escolhida.
Benchmarks: GPT-5.6 Sol Realmente Supera Claude e Gemini?
Depende do teste. Isso é o mais importante deste artigo, porque a resposta simplificada de “modelo X é o melhor” não sobrevive quando você olha os números lado a lado.
No Terminal-Bench 2.1 (avalia desempenho em programação agêntica via terminal), o Sol Ultra pontuou 91,9% e o Sol padrão 88,8%, à frente do Claude Mythos 5 (88,0%) e do GPT-5.5 (88,0%). No Coding Agent Index da Artificial Analysis, o Sol também liderou com pontuação 80.
Porém, no SWE-Bench Pro (benchmark de codificação em produção real, considerado por muitos desenvolvedores mais representativo do trabalho cotidiano do que testes de terminal isolados), quem lidera é o Claude, com Claude Fable 5 alcançando 80,3%, contra 64,6% do Sol e 58,6% do GPT-5.5. Essa é uma diferença de mais de 15 pontos percentuais, relevante o suficiente para pesar na decisão se o seu uso principal é gerar código para produção, não apenas resolver desafios isolados de terminal.
Atualização de setembro de 2026: desde então, a Anthropic lançou o Claude Fable 5.1 (1º de setembro de 2026), que elevou a pontuação da Anthropic no SWE-Bench Pro para 81,2%, a maior entre os modelos avaliados até a data desta atualização, ampliando a vantagem da Claude sobre o GPT-5.6 Sol nesse benchmark de codificação em produção. A Anthropic também reduziu o preço de leitura em cache do Fable 5.1 e do Mythos 5.1 em 75% (de US$ 1,00 para US$ 0,25 por milhão de tokens), o que na prática baixa o custo de uso em fluxos que reaproveitam bastante contexto, mesmo com o preço-base inalterado.
Um alerta que praticamente nenhum artigo em português menciona: o avaliador independente METR registrou, para o GPT-5.6, a maior taxa de “benchmark gaming” (comportamento do modelo otimizado especificamente para pontuar bem em testes, sem que isso reflita necessariamente ganho de capacidade real) já medida pela organização. Isso não invalida os números, mas é um motivo real para não confiar cegamente em uma única tabela de benchmark, seja ela da própria OpenAI ou de terceiros, e testar o modelo na sua tarefa específica antes de migrar toda uma operação.
Comparando com o Gemini 3.1 Pro (lançado em fevereiro de 2026): em comparações diretas com Claude Opus 5, o Gemini leva vantagem em contexto longo (janela de mais de 1 milhão de tokens de entrada) e em custo por token (cerca de 1,8 vez mais barato na média), mas fica atrás em benchmarks de codificação e agentes como SWE-Bench Pro, FrontierSWE e MCP Atlas.
Importante atualizar aqui: a vantagem de contexto do Gemini deixou de ser exclusiva. A partir de agosto de 2026, o GPT-5.6 Sol, Terra e Luna passaram a suportar janela de contexto de até 1 milhão de tokens em determinados provedores (como Amazon Bedrock), e o Claude também passou a oferecer janela completa de 1 milhão de tokens a partir da linha 4.6 em diante, incluindo Fable 5.1 e Mythos 5.1. Isso não elimina a vantagem de custo do Gemini em contexto longo, mas reduz a diferença técnica de tamanho de janela entre os três.
GPT-5.6 vs Claude vs Gemini: Resumo Prático de Qual Modelo Escolher
Resposta direta: não existe um único “melhor modelo” em 2026, existe o modelo certo para cada tarefa. Resumindo: Claude para código de produção, GPT-5.6 Sol para tarefas agênticas longas, Gemini 3.1 Pro para documentos longos e economia, e GPT-5.6 Terra para o uso balanceado do dia a dia. O gráfico abaixo resume essa comparação de forma visual.
Para fechar este comparativo GPT-5.6 vs Claude vs Gemini, aqui está a recomendação prática por tipo de tarefa:
Programação para produção (código que vai para um repositório real, não apenas resolver um desafio isolado): Claude segue na frente no SWE-Bench Pro.
Tarefas agênticas longas e autônomas (o modelo trabalha sozinho por várias etapas sem supervisão constante): GPT-5.6 Sol lidera no Agents’ Last Exam, com vantagem de mais de 13 pontos sobre o Claude Fable 5.
Documentos longos e contexto extenso (contratos, relatórios, bases de conhecimento grandes): Gemini 3.1 Pro continua sendo a opção mais econômica e com melhor retenção de contexto acima de 200 mil tokens.
Uso diário balanceado sem gastar muito: GPT-5.6 Terra é, por preço e desempenho declarado, a opção mais racional para a maioria das pequenas empresas e criadores de conteúdo em 2026, sendo a recomendação da própria OpenAI como ponto de partida.
Alto volume e baixa latência (triagem, classificação, primeira resposta automática): GPT-5.6 Luna, principalmente depois do corte de preço de 30 de julho, que o deixou 80% mais barato do que no lançamento.
O Que Isso Muda Para Quem Usa IA no Brasil
Resposta direta: a maior mudança não é qual modelo pontua mais alto em um benchmark isolado, é poder escalar entre camadas dentro da mesma família (Sol, Terra, Luna) conforme a complexidade da tarefa, cortando custo sem perder qualidade nos momentos em que ela importa.
Se você usa modelos de IA para atendimento no WhatsApp, criação de conteúdo ou automação de processos (temas que já tratamos em outros artigos deste site sobre agentes de IA para pequenas empresas), a mudança mais relevante não é qual modelo “ganha” no benchmark, é a nova lógica de precificação em camadas. Antes, trocar de modelo significava trocar de fornecedor inteiro. Agora, dentro de uma mesma família, você pode literalmente escalar o modelo conforme a complexidade da tarefa, usando Luna para responder perguntas simples e reservando o Sol apenas para os casos que realmente exigem raciocínio mais profundo. Isso reduz o custo operacional de um agente de IA sem abrir mão de qualidade nos momentos em que ela importa.
Vale registrar também que este tipo de comparação muda rápido. Os números aqui foram verificados em agosto de 2026, mas tanto a OpenAI quanto a Anthropic e o Google ajustam preços e lançam atualizações com frequência, como mostrou o próprio corte de preço do Terra e do Luna, feito três semanas depois do lançamento oficial. Vale a pena voltar a esta página periodicamente ou conferir a documentação oficial antes de fechar um contrato de longo prazo baseado só em preço.
Se você está começando a aplicar essas camadas de IA no seu dia a dia e quer ir além da teoria, vale explorar o que já reunimos aqui no site. Preparamos materiais gratuitos para quem quer testar prompts e fluxos sem custo antes de decidir onde investir tempo, além de guias em PDF com passo a passo detalhado para quem prefere seguir um processo estruturado em vez de aprender por tentativa e erro. Para quem já sabe qual tarefa quer resolver e só precisa de comandos prontos e testados, existem packs de prompts em PDF organizados por objetivo. E para quem busca uma formação mais completa, cobrindo um tema do início ao fim, também temos e-books que aprofundam os assuntos tratados de forma mais resumida nos artigos do blog.
Perguntas Frequentes sobre GPT-5.6, Claude e Gemini
O GPT-5.6 já está disponível para uso comercial no Brasil?
Sim. Desde 9 de julho de 2026, os três modelos da família (Sol, Terra e Luna) estão em disponibilidade geral via ChatGPT, Codex e API da OpenAI, sem restrição geográfica adicional específica para o Brasil além das já existentes para a plataforma. Antes disso, entre 26 de junho e 9 de julho, o acesso era limitado a cerca de 20 organizações pré-aprovadas pelo governo dos Estados Unidos, sob controle de exportação.
Qual é a diferença entre GPT-5.6 Sol, Terra e Luna?
Sol é o modelo mais avançado, indicado para raciocínio complexo, tarefas agênticas longas, programação difícil e cibersegurança, ao custo de US$ 5 de entrada e US$ 30 de saída por milhão de tokens. Terra entrega desempenho próximo ao GPT-5.5 por cerca de metade do preço, sendo a opção recomendada pela própria OpenAI para a maioria dos usos. Luna é o mais rápido e barato, voltado para tarefas de alto volume e baixa complexidade, atualmente custando US$ 0,20 de entrada e US$ 1,20 de saída por milhão de tokens após o corte de preço de 30 de julho de 2026.
GPT-5.6 é melhor que o Claude para programar?
Depende do tipo de tarefa de programação. Em benchmarks de codificação agêntica via terminal, como o Terminal-Bench 2.1, o GPT-5.6 Sol supera o Claude. Já em codificação de produção real, medida pelo SWE-Bench Pro, o Claude Fable 5 tem vantagem clara, pontuando 80,3% contra 64,6% do Sol. Se o seu trabalho é gerar código para um repositório de produção, o Claude ainda leva vantagem nos números públicos disponíveis; se é automação agêntica de tarefas longas, o Sol tem a melhor pontuação divulgada.
Vale a pena trocar do GPT-5.5 para o GPT-5.6?
Para a maioria dos usos cotidianos, sim, principalmente migrando para o GPT-5.6 Terra, que a OpenAI descreve como equivalente em desempenho ao GPT-5.5 por aproximadamente metade do custo por token. A troca faz menos sentido apenas se você já tem um fluxo de trabalho estável no GPT-5.5 e não sente necessidade de reduzir custo ou ganhar velocidade no momento.
Qual modelo de IA é mais barato em 2026: GPT-5.6, Claude ou Gemini?
Considerando as camadas de entrada, o GPT-5.6 Luna é atualmente o mais barato entre os três, a US$ 0,20 por milhão de tokens de entrada. Olhando para os modelos de topo de linha, o Gemini 3.1 Pro costuma sair mais barato por token do que o Claude Opus e o GPT-5.6 Sol, especialmente abaixo de 200 mil tokens de contexto, embora o preço suba significativamente acima desse limite.
O que significa “camadas de capacidade duráveis” no GPT-5.6?
É o novo sistema de nomenclatura da OpenAI, em que o número da versão (5.6) identifica a geração do modelo, enquanto os nomes Sol, Terra e Luna identificam níveis de capacidade que podem evoluir de forma independente, sem esperar o lançamento de uma geração inteira nova. Na prática, isso significa que a OpenAI pode atualizar ou otimizar, por exemplo, apenas o Luna, sem alterar o Sol ou o Terra, como já aconteceu com o corte de preço de 30 de julho de 2026.
Qual será o próximo modelo depois do GPT-5.6? Vale a pena esperar?
Sim, mas por pouco tempo: em 3 de setembro de 2026 a OpenAI já lançou o GPT-6 Astra, sucessor do GPT-5.6 Sol, custando US$ 10 de entrada e US$ 50 de saída por milhão de tokens. Isso confirma o padrão observado ao longo de 2026: a OpenAI lançou sete atualizações de geração no ano (GPT-5.2 em dezembro de 2025, GPT-5.4 em março, GPT-5.5 em abril, GPT-5.6 em julho e GPT-6 Astra em setembro), um ritmo de aproximadamente uma grande atualização a cada dois meses. Esperar o “modelo perfeito” para começar a usar IA de forma séria simplesmente não funciona, porque sempre vai existir um modelo mais novo no horizonte antes que a decisão seja tomada. A escolha certa continua sendo a camada que resolve o seu problema agora (Sol, Terra ou Luna no GPT-5.6, ou o Astra para tarefas de ponta como automação de navegador e terminal), não a versão mais recente por si só, já que trocar de camada dentro da mesma família costuma ser simples e rápido quando uma atualização relevante chegar.
Conclusão
Se você chegou até aqui, já sabe mais sobre o GPT-5.6 do que a maioria dos artigos em português publicados até agora: sabe que não é um modelo único, sabe os preços reais de cada camada antes e depois do corte de 30 de julho, sabe em quais benchmarks o Sol realmente vence o Claude e em quais perde, e sabe qual camada faz sentido para o seu caso específico, seja você alguém que programa, cria conteúdo ou automatiza atendimento.
O erro mais comum nesse momento não é escolher o modelo errado, é gastar tempo demais comparando tabelas de benchmark em vez de testar. Os números deste artigo foram verificados em fontes oficiais, mas nenhum benchmark substitui rodar a sua tarefa real dentro do seu fluxo de trabalho. Se você automatiza atendimento no WhatsApp ou cria conteúdo em escala, o caminho mais racional é começar pelo Terra, medir o resultado com as suas próprias métricas por uma ou duas semanas, e só então decidir se vale subir para o Sol nos casos mais exigentes ou descer para o Luna nas tarefas mais simples e repetitivas.
O mercado de IA muda rápido demais para tratar qualquer escolha como definitiva. A vantagem de quem entende a lógica das camadas, em vez de decorar o nome de um modelo, é justamente essa: continuar tomando boas decisões mesmo quando a OpenAI, a Anthropic ou o Google lançarem a próxima atualização, o que, pelo ritmo visto em 2026, deve acontecer em poucos meses.
Ficou com alguma dúvida? Se quiser tirar dúvidas diretamente, clique aqui para nos contatar por e-mail. Se preferir uma resposta mais rápida, fale com um de nossos agentes ou converse com nosso assistente de IA no chat, disponível no canto inferior direito da página.