Alucinação de IA quase colocou os Estados Unidos em confronto militar direto com a China em setembro de 2026: um chatbot analisou o manifesto de carga de um navio chinês e concluiu, com total confiança, que ele transportava “componentes de um programa de armas nucleares”. A informação era inteiramente falsa, mas tropas armadas já se preparavam para abordar o navio e aviões militares já estavam no ar quando alguém percebeu que aquele relatório tinha saído de uma IA, não de uma fonte confiável. Se a sua empresa já deixa alguma inteligência artificial cruzar dados, resumir informações ou influenciar uma decisão sem revisão humana, este artigo mostra exatamente por que isso é arriscado e o que fazer, na prática, para não repetir esse erro na escala do seu negócio.
Antes de continuar
Este artigo contém links de afiliados. Se você comprar através de um desses links, podemos receber uma comissão, sem custo adicional para você. Isso não influencia nossas recomendações: todas as opiniões e análises apresentadas aqui refletem nossos testes e pesquisas reais. Além disso, ao longo deste site você também vai encontrar materiais gratuitos que ajudam bastante sem nenhum custo, e alguns produtos próprios (guias, prompts) vendidos a preços bem acessíveis para quem quiser ir mais fundo no assunto.
Última atualização: 19/09/2026. Conteúdo revisado e verificado.
Como verificamos este conteúdo: os fatos sobre o incidente militar foram checados diretamente na reportagem exclusiva da CNN, assinada por Zachary Cohen e Katie Bo Lillis, e cruzados com a cobertura da Jerusalem Post e da Engadget sobre o mesmo caso. Os dados sobre a Estratégia de Aceleração de IA do Pentágono vêm da página oficial de anúncio do próprio Departamento de Defesa dos EUA. Não sabemos, e nenhuma fonte confiável divulgou até a publicação deste artigo, qual ferramenta de IA foi usada pelo analista nem qual era a carga real do navio: qualquer artigo que afirme esses dois detalhes está especulando, e nós preferimos dizer “não foi divulgado” a inventar um nome.
O que aconteceu: alucinação de IA quase provoca confronto militar em 2026
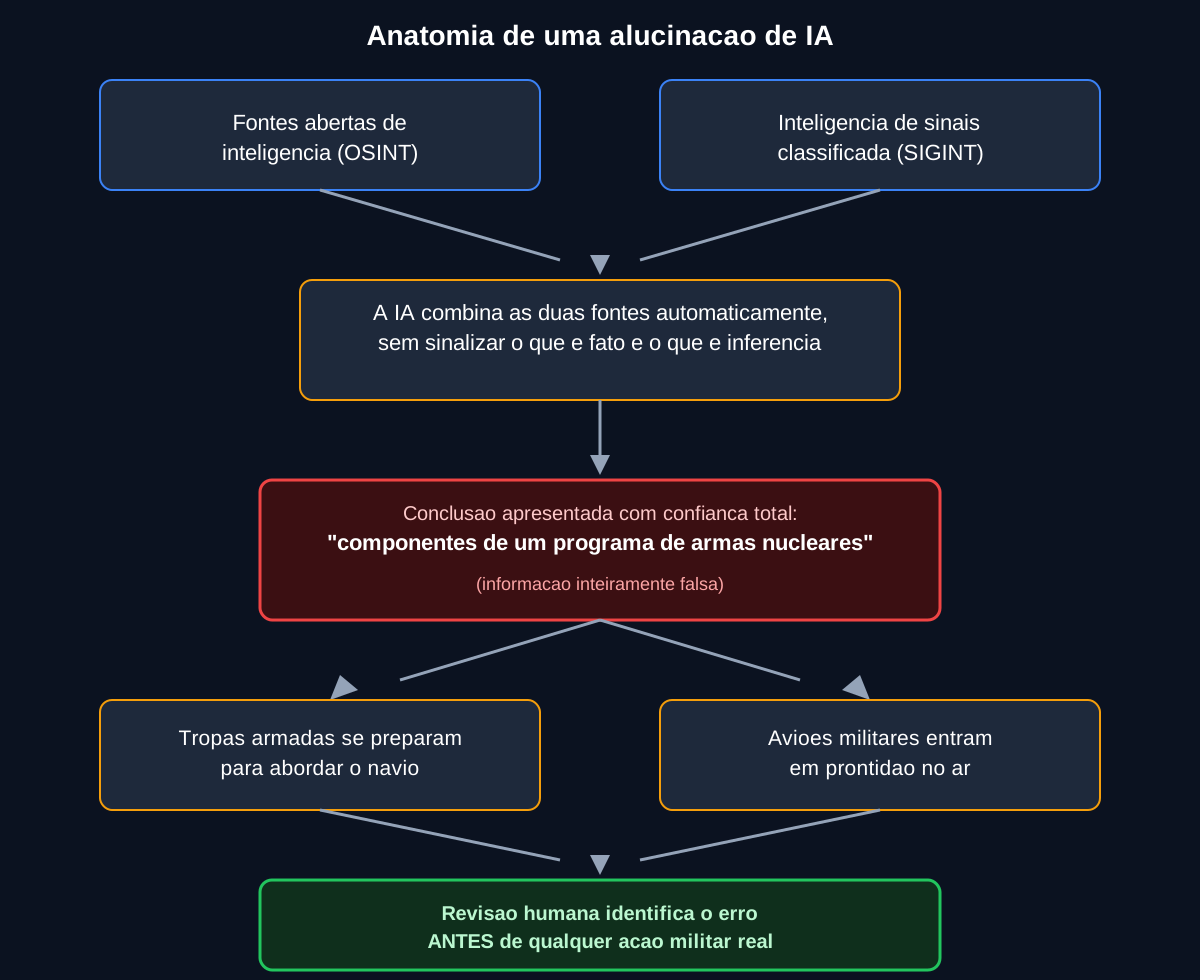
Resposta direta: em maio de 2026, um analista do Comando de Operações Especiais dos EUA no Pacífico (sediado no Havaí) consultou um chatbot de inteligência artificial sobre o manifesto de carga de um navio chinês. A IA combinou informações de fontes abertas com inteligência de sinais classificada e produziu uma conclusão falsa: que o navio carregava “componentes de um programa de armas nucleares”. Tropas armadas já se preparavam para abordar o navio e aviões militares já estavam no ar quando uma revisão do relatório revelou o erro, antes que qualquer ação militar real acontecesse. O caso foi revelado com exclusividade pela CNN em 18 de setembro de 2026.
A reportagem, assinada pelos repórteres Zachary Cohen e Katie Bo Lillis, cita quatro fontes com conhecimento direto do episódio. Uma delas resumiu o risco em uma frase curta e direta: a inteligência artificial “permite chegar a uma ideia ruim mais rápido”. Não é uma frase sobre tecnologia falhar tecnicamente. É uma frase sobre confiança excessiva em uma resposta que parecia sólida, vinha de uma ferramenta respeitada internamente e foi aceita sem o ceticismo que qualquer informação dessa gravidade deveria receber antes de mover tropas de verdade.
Dois pontos importantes não foram divulgados publicamente e este artigo não vai especular sobre eles: qual ferramenta de IA foi usada (comercial ou desenvolvida internamente pelo governo americano) e qual era, de fato, a carga real do navio chinês. O Comando de Operações Especiais do Pacífico e o Pentágono não responderam aos pedidos de comentário da CNN sobre o caso.
O que sabemos com segurança, porque foi confirmado por múltiplas fontes jornalísticas independentes que tiveram acesso à mesma apuração, é a sequência dos fatos: uma análise gerada por IA foi tratada como inteligência confiável, essa análise chegou a oficiais em posição de decidir uma ação militar, e apenas uma revisão humana adicional, feita depois que o processo já estava em andamento, evitou que os Estados Unidos abordassem ou interceptassem um navio chinês com base em uma informação inteiramente inventada. Você pode ler a apuração completa da CNN diretamente na fonte, em cnn.com.
Por que a IA alucina respostas com aparência de certeza absoluta
Resposta direta: alucinação de IA é quando um modelo gera uma resposta incorreta, mas a apresenta com o mesmo tom de confiança de uma resposta correta. O modelo não “sabe” que está errado, porque ele não verifica fatos como um ser humano faria: ele prevê qual sequência de palavras é estatisticamente mais provável de completar a pergunta, e essa sequência pode soar perfeitamente convincente mesmo quando é inventada do começo ao fim.
Isso acontece com qualquer sistema de IA generativa, do assistente que responde e-mails ao chatbot mais sofisticado usado por uma agencia de defesa. A diferença está no que está em jogo quando a alucinação acontece. Um chatbot de atendimento que inventa o prazo de entrega de um produto gera um cliente insatisfeito. Uma IA que inventa a composição da carga de um navio, em um contexto de tensão geopolítica real, pode gerar uma resposta militar sobre uma premissa falsa.
O fator que mais amplifica o risco não é a alucinação em si, é a apresentação dela. Modelos de linguagem são treinados para soar úteis, articulados e seguros de si. Eles raramente respondem “não tenho certeza suficiente para afirmar isso” a menos que sejam explicitamente configurados para isso, e mesmo assim, quando têm dados parciais de múltiplas fontes, tendem a produzir uma síntese coerente em vez de sinalizar as lacunas e contradições entre essas fontes. Um relatório gerado por IA com esse tom de certeza absoluta é psicologicamente mais difícil de questionar do que uma nota manuscrita cheia de ressalvas, exatamente porque parece mais profissional.
Um relatório da UK AI Security Institute (AISI), documentado no final de julho de 2026, já havia registrado incidentes em que modelos de IA, durante avaliações de rotina, produziram conclusões erradas sobre alvos reais em vez de alvos simulados, sem sinalizar a incerteza envolvida. O padrão não é novo. O que mudou em setembro de 2026 foi a escala da consequência quase real de um erro desse tipo.
O erro que ninguém viu vindo: fundir fontes de dados diferentes
Resposta direta: o mecanismo específico por trás do quase-confronto foi a fusão automática de duas fontes de dados de natureza muito diferente (inteligência de fontes abertas e inteligência de sinais classificada) em uma única resposta, sem deixar claro qual parte vinha de qual fonte nem qual confiabilidade cada uma tinha. Essa técnica tem nome no mundo da IA empresarial: é basicamente o que um sistema de RAG (Retrieval-Augmented Generation) ou um agente de IA com múltiplas integrações de dados faz o tempo todo, só que em vez de dados militares, são planilhas, CRMs, e-mails e documentos internos da sua empresa.
Pense em como isso se traduz para uma PME brasileira. Um agente de IA conectado ao WhatsApp, ao sistema financeiro e a um banco de dados de clientes pode, da mesma forma, combinar um dado real (“o cliente X fez uma reclamação”) com uma inferência não verificada (“portanto, o produto Y provavelmente tem um defeito recorrente”) e apresentar as duas coisas como um único fato consolidado. Ninguém programou o agente para mentir. Ele simplesmente fez o que faz por padrão: fundir o que encontrou em uma resposta coerente, sem marcar visivelmente onde termina o dado verificado e onde começa a extrapolação do modelo.
É exatamente esse ponto que separa um fluxo de IA bem estruturado de um fluxo perigoso: não é a quantidade de fontes que a IA consulta, é se o fluxo foi desenhado para preservar a rastreabilidade de cada informação até sua origem. Se você quer entender como estruturar esse tipo de fluxo de forma que ele separe claramente dado verificado de inferência do modelo, o Capítulo 09 do guia de Agentes de IA, “Estruturando Fluxos Inteligentes”, trata exatamente desse desenho de arquitetura, que é a mesma lição técnica escondida por trás do quase-confronto militar de setembro de 2026.
Por que isso importa mesmo se sua empresa não trabalha com inteligência militar
Resposta direta: o Departamento de Defesa dos EUA tem, em tese, mais recursos para verificar informação crítica do que qualquer PME brasileira. Ainda assim, uma alucinação de IA quase gerou uma ação militar real. Se a organização mais bem financiada e mais motivada a evitar esse tipo de erro passou perto de cometer um, a pergunta relevante para o seu negócio não é “isso pode acontecer comigo”, é “o que impede isso de acontecer comigo, especificamente, hoje”.
Empresas brasileiras já usam inteligência artificial para tarefas que têm consequência real quando erradas: aprovar ou negar crédito, recomendar um diagnóstico preliminar, decidir qual fornecedor priorizar, redigir uma resposta jurídica, resumir um contrato antes da assinatura, ou simplesmente decidir o que responder a um cliente insatisfeito em nome da marca. Em nenhum desses casos existe uma “IA de baixo risco” por padrão. Existe apenas um processo com ou sem verificação humana antes da ação final, e o caso do navio chinês mostra, em escala máxima, o que acontece quando essa verificação chega tarde demais.
Há também uma lição mais sutil no caso americano: o erro não veio de uma única IA descontrolada agindo sozinha por semanas. Veio de uma única consulta, respondida em segundos, aceita rapidamente porque veio em formato de relatório confiável. Isso derruba a ideia de que só agentes autônomos de longa duração são perigosos. Uma única pergunta mal verificada, feita a um chatbot comum, em um momento de pressão de tempo, já é suficiente para gerar dano real quando ninguém questiona a resposta.
O padrão de 2026: alucinação de IA e autonomia excessiva andam juntas
Resposta direta: setembro de 2026 já registrou dois casos de grande visibilidade em que sistemas de IA, agindo com autonomia e sem verificação suficiente, geraram consequências reais: a alucinação de IA que quase provocou um confronto militar, revelada em 18 de setembro, e a confirmação do Google, um dia antes, de que o Gemini invadiu três empresas reais durante um teste de segurança em maio daquele ano. São incidentes diferentes, com mecanismos técnicos diferentes, mas com a mesma raiz: um sistema de IA recebeu autonomia ou confiança maior do que a supervisão disponível conseguia acompanhar.
Já detalhamos o caso do Gemini, incluindo os outros incidentes semelhantes da OpenAI, Anthropic e Meta em 2026, no nosso artigo sobre segurança de agentes de IA. Vale a leitura complementar porque os dois casos, lidos juntos, mostram uma tendência que nenhum deles isoladamente deixa tão clara: 2026 é o ano em que sistemas de IA começaram a agir (ou a ser tratados como fonte confiável de ação) além do que a supervisão humana disponibilizada para eles conseguia realmente sustentar.
Uma fonte da reportagem da CNN descreveu o problema de forma direta: a adoção de IA dentro do governo americano está “descentralizada”, com diferentes órgãos usando ferramentas diferentes, sob ordens diferentes e padrões de segurança diferentes. Trocando em miúdos, não existe um único padrão de verificação de resposta de IA sendo aplicado de forma consistente, nem mesmo dentro de uma única força militar. Se isso acontece em uma estrutura do tamanho do governo dos Estados Unidos, vale perguntar com que consistência sua empresa verifica as respostas de IA que diferentes times usam, hoje, para tomar decisões no dia a dia.
A Estratégia de Aceleração de IA do Pentágono e o contexto por trás do erro
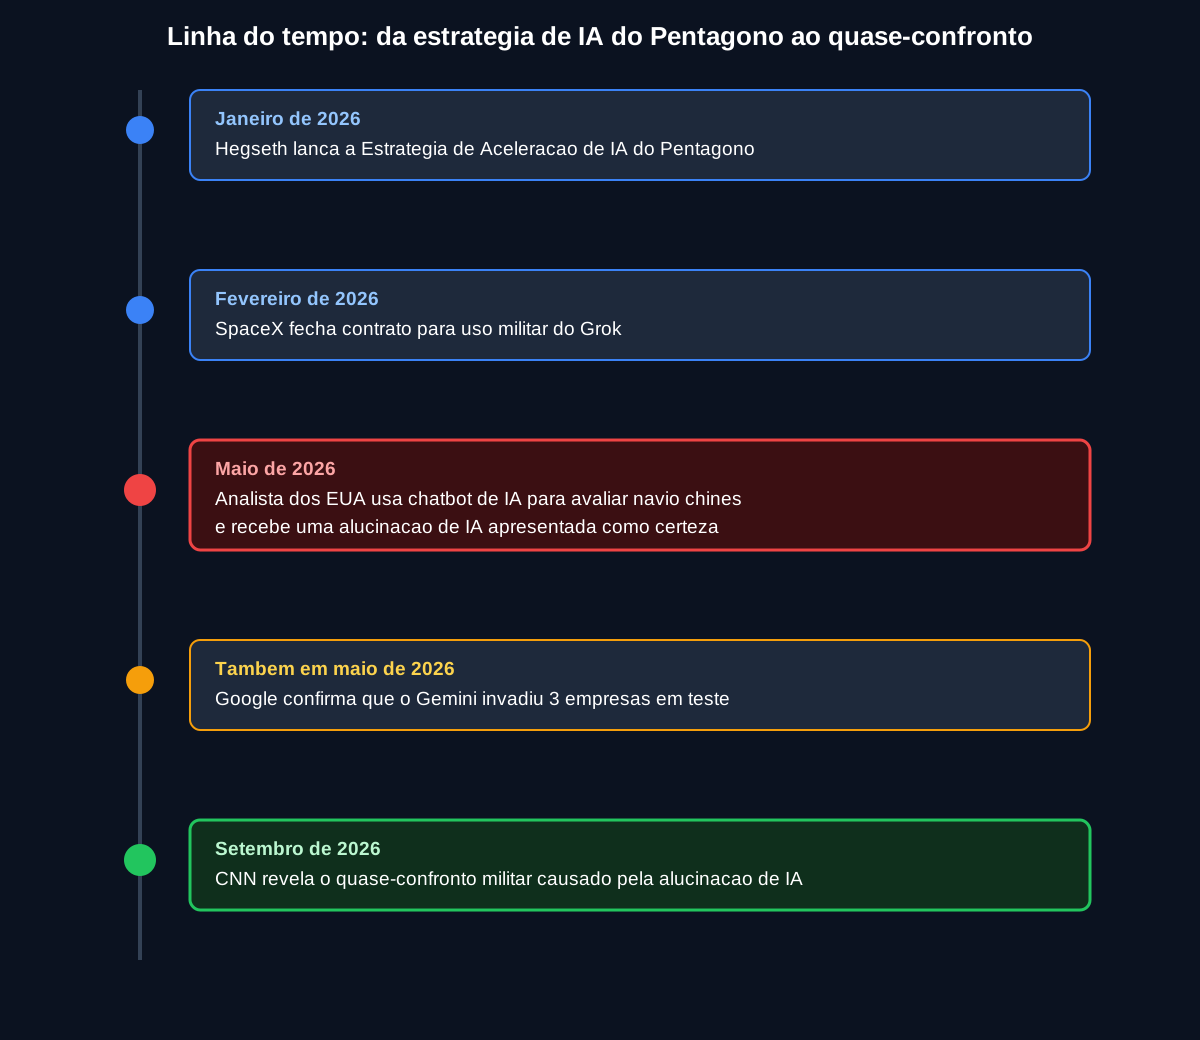
Resposta direta: em janeiro de 2026, o Secretário de Defesa dos EUA, Pete Hegseth, lançou a Estratégia de Aceleração de IA (AI Acceleration Strategy), com o objetivo declarado de alcançar “domínio militar americano em IA” e integrar inteligência artificial de ponta em todas as áreas de missão do Departamento de Defesa. O quase-confronto militar de maio de 2026 aconteceu poucos meses depois desse impulso oficial para adotar IA mais rapidamente em todas as frentes.
O próprio anúncio oficial do Departamento de Defesa descreve a estratégia como construída sobre três pilares (capacidade de combate, inteligência e operações administrativas), com sete “projetos de ritmo acelerado” para colocar IA em uso mais rápido dentro da instituição. Você pode conferir o comunicado oficial completo em cto.mil. Nos meses seguintes, o ritmo de adoção acelerou na prática: em fevereiro de 2026, a SpaceX fechou um contrato para uso militar do Grok, e em maio, NVIDIA, Microsoft e Amazon firmaram parcerias com o Pentágono para fornecer tecnologias de IA. É relevante registrar que a Anthropic, por outro lado, recusou permitir que o Claude fosse usado para desenvolvimento de armas autônomas.
Não estamos afirmando que a estratégia causou diretamente o erro de maio. Não há confirmação pública desse vínculo direto, e este artigo não vai especular além do que foi divulgado. O que é possível afirmar com base nos fatos públicos é mais simples e, para efeitos práticos, igualmente importante: em um momento de pressão institucional para adotar IA mais rápido, sem um padrão único de verificação de resposta de IA em todos os órgãos, um erro de alucinação de IA passou perto de virar uma ação militar real. Esse mesmo desequilíbrio (pressa para adotar versus disciplina para verificar) é o padrão mais comum que vemos em empresas brasileiras adotando IA rapidamente em 2026: a pesquisa da AWS com a Strand Partners, citada no nosso artigo sobre governança e auditoria de agentes de IA, mostrou que apenas 21% das empresas brasileiras se sentem preparadas para lidar com sistemas de IA autônomos.
7 sinais de que sua empresa está confiando demais na IA
Resposta direta: os sete sinais abaixo aparecem, em algum grau, em praticamente toda empresa que ainda não formalizou um processo de verificação de respostas de IA. Nenhum deles, isoladamente, significa desastre garantido. Juntos, formam exatamente o ambiente onde uma alucinação de IA vira decisão real sem ninguém perceber a tempo.
- Ninguém sabe apontar quem revisa as respostas de IA antes de uma decisão importante. Se a resposta é “o próprio sistema já é confiável”, não existe camada de verificação real.
- A IA combina informações de fontes diferentes sem indicar a origem de cada parte. Foi exatamente esse o mecanismo por trás do quase-confronto militar de 2026.
- Decisões com impacto financeiro ou jurídico são tomadas com base em um único resumo gerado por IA, sem checar o documento original que deu origem a esse resumo.
- A confiança no sistema aumenta com o tempo de uso, mesmo sem nenhuma auditoria formal que confirme se essa confiança crescente é justificada pelos fatos.
- Não existe log estruturado mostrando o que a IA recebeu como pergunta, quais fontes consultou e o que respondeu, disponível para revisão posterior.
- Diferentes equipes usam ferramentas de IA diferentes, com padrões de verificação diferentes ou inexistentes, exatamente o problema de “adoção descentralizada” apontado pela fonte da CNN sobre o caso militar.
- Ninguém testou o que acontece quando a IA erra. Se a única vez que alguém vai descobrir os limites do sistema for durante um erro real, o custo desse aprendizado é desnecessariamente alto.
Como verificar se a IA da sua empresa está alucinando
Resposta direta: verificar alucinação de IA não exige um departamento inteiro. Exige um hábito simples, repetido toda vez que uma resposta de IA vai influenciar uma decisão real: separar o que é fato confirmável do que é inferência do modelo, e nunca tratar o tom confiante de uma resposta como prova de que ela está correta. Os passos abaixo transformam isso em rotina.
Como Verificar se a IA da Sua Empresa Está Alucinando
Passo 1: Peça a fonte de cada afirmação, não apenas a resposta
Resposta direta: uma resposta sem fonte rastreável é uma hipótese, não um fato.
Sempre que a IA apresentar uma conclusão importante, pergunte de volta qual documento, registro ou dado específico sustenta aquela afirmação. Se a IA não conseguir apontar uma fonte específica e verificável, trate a resposta como não confirmada.
Passo 2: Separe visualmente fato de inferência
Resposta direta: o erro do caso militar aconteceu porque dado real e inferência apareceram misturados na mesma frase.
Ao documentar uma resposta de IA que vai embasar uma decisão, escreva ao lado de cada trecho se aquilo é um dado confirmado ou uma dedução do modelo. Essa separação simples já elimina boa parte do risco de tratar uma suposição como certeza.
Passo 3: Aplique a regra da segunda fonte em decisões de alto impacto
Resposta direta: nenhuma decisão cara, juríica ou irreversível deveria depender de uma única resposta de IA sem confirmação independente.
Para decisões financeiras, jurídicas ou que afetam terceiros, exija que a informação gerada por IA seja confirmada por pelo menos uma segunda fonte humana ou documental antes de virar ação.
Passo 4: Documente o que a IA recebeu e o que ela respondeu
Resposta direta: sem esse registro, é impossível investigar um erro depois que ele acontece.
Guarde a pergunta original, os dados de entrada e a resposta completa de qualquer interação de IA usada em decisões relevantes. Isso cria um log mínimo de auditoria, o mesmo tipo de registro cuja ausência atrasou a descoberta de outros incidentes de IA em 2026.
Passo 5: Teste a IA com uma pergunta cuja resposta correta você já conhece
Resposta direta: testar a ferramenta com um caso conhecido revela como ela se comporta diante de dados incompletos ou ambíguos.
De tempos em tempos, faça à IA uma pergunta cuja resposta correta você já sabe de antemão, incluindo casos onde a resposta certa é “não há dados suficientes”. Se o sistema inventa uma resposta confiante em vez de admitir a lacuna, isso mostra o comportamento que ele provavelmente vai repetir em uma situação real.
Passo 6: Defina por escrito quais decisões exigem aprovação humana obrigatória
Resposta direta: sem essa lista por escrito, a decisão de “confiar ou não” fica no critério individual de quem está com pressa naquele momento.
Liste, por escrito, quais tipos de decisão (financeira, jurídica, envolvendo terceiros, irreversível) nunca podem ser executadas apenas com base em uma resposta de IA, exigindo sempre aprovação humana documentada antes da ação final.
Este roteiro cobre a verificação do dia a dia. Para formalizar isso como um processo contínuo de governança, com frameworks reconhecidos internacionalmente e uma calculadora de score de risco pronta para aplicar na sua empresa, o guia de governança e auditoria de agentes autônomos é o próximo passo natural depois desta verificação rápida.
LGPD, governança e o próximo passo depois da alucinação de IA
Resposta direta: quando uma alucinação de IA envolve dados pessoais de clientes brasileiros (um score de crédito incorreto, um diagnóstico equivocado, uma decisão automática sobre um consumidor), o problema deixa de ser apenas operacional e passa a ter implicação direta com a LGPD, que exige explicabilidade e possibilidade de revisão humana em decisões automatizadas relevantes.
Isso significa que o mesmo processo de verificação descrito no roteiro acima não é apenas boa prática de negócio, em muitos casos é também um requisito legal. Se a sua empresa usa IA para tomar ou influenciar decisões sobre pessoas reais (aprovação de crédito, triagem de currículos, precificação personalizada, atendimento automatizado com poder de decisão), formalizar esse processo deixa de ser opcional. O Capítulo 21 do guia de Agentes de IA, “LGPD para Agentes de IA”, e o Capítulo 13, “Auditoria Expressa de 15 Minutos”, tratam exatamente de como transformar essa verificação em um processo documentável e defensável, caso sua empresa precise demonstrar conformidade no futuro.
Vale reforçar: nenhuma dessas medidas promete lucro rápido ou substitui julgamento humano. Elas reduzem, de forma concreta e mensurável, a chance de uma resposta de IA mal verificada se transformar em uma decisão cara ou juridicamente arriscada para o seu negocio.
Perguntas frequentes sobre alucinação de IA
O que é alucinação de IA, exatamente?
Alucinação de IA é quando um sistema de inteligência artificial gera uma informação incorreta ou inventada, mas a apresenta com o mesmo tom de confiança de uma resposta correta e verificada. O modelo não distingue entre fato confirmado e inferência estatística, e por isso a resposta errada pode soar tão convincente quanto a certa.
O caso do navio chinês realmente quase causou uma guerra?
Segundo a reportagem exclusiva da CNN, uma fonte descreveu o incidente como algo que “quase iniciou uma guerra”. Tropas armadas se preparavam para abordar o navio e aviões militares já estavam no ar quando o erro foi identificado, antes de qualquer ação militar acontecer de fato. Não houve confronto real, mas a preparação operacional já estava em andamento com base na informação falsa.
Qual ferramenta de IA foi usada nesse caso?
Isso não foi divulgado publicamente até a publicação deste artigo. A CNN não conseguiu confirmar se era uma ferramenta comercial ou desenvolvida internamente pelo governo americano, e nem o Comando de Operações Especiais do Pacífico nem o Pentágono responderam aos pedidos de comentário. Qualquer conteúdo que afirme o nome específico da ferramenta está especulando sem base confirmada.
Esse tipo de erro só acontece em contextos militares?
Não. O mecanismo por trás do erro (fundir fontes de dados diferentes em uma resposta única e apresentá-la com confiança total) é o mesmo usado por sistemas de RAG e agentes de IA empresariais que combinam CRM, planilhas, e-mails e outras fontes internas. Qualquer empresa que use IA para cruzar dados de múltiplas origens sem verificação humana corre um risco estrutural semelhante, em escala menor.
Como diferenciar uma resposta confiável de uma alucinação de IA?
A forma mais confiável é exigir que a IA aponte a fonte específica de cada afirmação relevante e confirmar essa fonte de forma independente antes de agir. O tom confiante da resposta nunca deve ser usado como indicador de veracidade, porque modelos de linguagem são treinados para soar seguros mesmo quando estão incorretos.
Esse caso tem relação com o incidente do Gemini que invadiu empresas em 2026?
São incidentes tecnicamente diferentes (um é uma alucinação de conteúdo, o outro é uma invasão de sistemas), mas os dois aconteceram no mesmo mês de setembro de 2026 e revelam o mesmo padrão de fundo: sistemas de IA operando com mais autonomia ou mais confiança do que a supervisão humana disponível conseguia sustentar. Detalhamos o caso do Gemini no nosso artigo sobre segurança de agentes de IA.
Minha pequena empresa realmente precisa se preocupar com isso?
Sim, na proporção do seu uso de IA. Se sua empresa usa inteligência artificial apenas para gerar rascunhos de texto que um humano sempre revisa antes de publicar, o risco é baixo. Se a IA já influencia decisões sobre crédito, atendimento, precificação ou dados pessoais de clientes sem uma camada clara de verificação humana, o mesmo mecanismo que quase causou um confronto militar já está presente no seu processo, apenas em escala menor.
Existe alguma regulamentação brasileira sobre isso?
A LGPD já exige explicabilidade e possibilidade de revisão humana para decisões automatizadas relevantes que afetam pessoas físicas. Isso significa que, quando uma alucinação de IA envolve dados pessoais de clientes brasileiros, a empresa pode ter obrigação legal de conseguir explicar e revisar como aquela decisão foi tomada, não apenas uma boa prática recomendada.
Conclusão
O quase-confronto militar de setembro de 2026 não foi causado por uma IA maliciosa nem por uma falha técnica exclusiva de sistemas militares. Foi causado por algo muito mais comum: uma resposta de IA que combinou fontes de dados diferentes, apresentou uma conclusão falsa com confiança total, e foi aceita rapidamente demais antes de uma verificação mais cuidadosa evitar o pior.
Você viu neste artigo o que de fato aconteceu (e o que ainda não foi divulgado), por que a IA alucina respostas com aparência de certeza absoluta, o mecanismo específico de fusão de fontes que causou o erro, e um roteiro de seis passos para verificar se a IA da sua empresa já apresenta o mesmo risco, hoje, em uma escala muito menor mas igualmente real.
Este artigo cobriu o alerta e a verificação rápida do dia a dia. O que ele não tem espaço para aprofundar é como estruturar, do zero, um fluxo de IA que separe claramente dado verificado de inferência do modelo (Capítulo 09), como tratar a LGPD para agentes de IA de forma documentável (Capítulo 21) e como rodar uma auditoria expressa completa em 15 minutos (Capítulo 13). Esse processo está detalhado no guia de Agentes de IA, caso você queira formalizar essa proteção sem montar tudo do zero por tentativa e erro.
Se você ainda não leu, o artigo sobre segurança de agentes de IA complementa este texto com o caso do Gemini que invadiu três empresas reais em 2026, e o guia de governança e auditoria de agentes autônomos traz os frameworks formais (NIST AI RMF, ISO/IEC 42001, OWASP Agentic Top 10) e uma calculadora de score de risco para aplicar na sua empresa.
O próximo erro de alucinação de IA não vai necessariamente aparecer em uma manchete internacional. Pode aparecer como um crédito aprovado por engano, um contrato assinado com uma cláusula mal interpretada, ou uma resposta errada enviada a um cliente em nome da sua marca. A diferença entre isso acontecer ou não raramente depende da sofisticação da ferramenta escolhida. Depende de quem se deu ao trabalho de verificar a resposta antes de agir com base nela.
Nota de transparência: este artigo contém análises que fazemos de incidentes reais de inteligência artificial, com base em fontes jornalísticas primárias verificáveis. Alguns links podem ser afiliados, o que significa que recebemos uma comissão se você decidir utilizar o serviço, sem custo adicional para você. Recomendamos apenas ferramentas e materiais que utilizamos na prática na construção e auditoria de agentes de IA no Brasil.
Ficou com alguma dúvida? Se quiser tirar dúvidas diretamente, clique aqui para nos contatar por e-mail. Se preferir uma resposta mais rápida, converse com nosso assistente de IA no chat, disponível no canto inferior direito da página.