Última atualização: 16/11/2026. Configuração revisada para n8n 1.x, Evolution API v2 e os modelos atuais da Groq.
Um chatbot WhatsApp grátis n8n é possível de montar combinando n8n, Evolution API e Groq, com um custo fixo de servidor de poucos dólares por mês. Mas a maioria dos tutoriais em português para nesse ponto e não conta o resto: sem PostgreSQL, o n8n em produção trava em escritas simultâneas sob carga; sem publicar as portas só em localhost, o Nginx e a Evolution API podem disputar a mesma porta; sem o community node dedicado, você reescreve na mão o que já existe pronto e mantido pela comunidade. Este guia cobre a montagem completa de ponta a ponta, incluindo os pontos onde a maioria dos projetos trava.
Se você já leu nosso comparativo de custos entre o Meta Business Agent e um agente próprio e decidiu que o caminho DIY compensa para o seu volume de mensagens, este é o guia de montagem prática que continua de onde aquele artigo parou.
Chatbot WhatsApp Grátis n8n: Para Quem é Este Guia
Resposta direta: este guia é para quem já decidiu montar o próprio agente de atendimento e está à vontade para rodar comandos básicos de terminal por pelo menos uma tarde; não é para quem quer uma solução pronta em cinco minutos sem nenhuma manutenção. Se você se encaixa no primeiro grupo, siga a leitura na ordem: os dez passos abaixo dependem uns dos outros.
Este tutorial tem dois níveis de profundidade misturados de propósito. Se você nunca abriu um terminal, siga cada comando literalmente, copiando e colando. Se você já mexe com servidores, pule direto para a arquitetura Docker com rede explícita e PostgreSQL: é ali que está o ganho real de tempo em relação a montar tudo com HTTP Request bruto.
O que você vai precisar:
- Um número de celular sem vínculo com nenhuma conta pessoal do WhatsApp
- Uma VPS com pelo menos 2 vCPUs e 4 GB de RAM. A VPS.org tem planos com painel de administração incluído, o que ajuda se você nunca configurou um servidor Linux do zero, mas qualquer provedor com acesso root e Ubuntu 22.04 ou 24.04 funciona igual para este guia
- Um domínio próprio com dois registros DNS apontando para o IP da VPS: um para o n8n (ex.:
seu-dominio.com) e outro para a Evolution API (ex.:evo.seu-dominio.com) - Uma conta gratuita na Groq Console
- De 2 a 4 horas na primeira montagem
Por Que Essa Stack e Quando Ela Não é a Escolha Certa
Resposta direta: essa stack compensa quando o volume de mensagens ainda é baixo ou médio, quando existe alguém disposto a fazer manutenção mínima de servidor, e quando o negócio pode tolerar o risco pequeno, mas real, de o número precisar ser reconectado de vez em quando. Ela não compensa para operações que dependem de SLA formal com a Meta ou que não podem correr risco nenhum de instabilidade.
O WhatsApp Business API oficial da Meta exige verificação de empresa e, dependendo do volume, cobra por mensagem. A Evolution API é um projeto open source mantido pela comunidade brasileira que conecta ao WhatsApp via QR Code, do mesmo jeito que o WhatsApp Web, sem passar pela homologação da Meta.
Atualização de setembro de 2026: o projeto Evolution API segue ativo e gratuito, mas a governança do repositório passou para a organização Evolution Foundation no GitHub, que mantém o código aberto (confira os termos de licença no repositório). A documentação oficial atual fica em docs.evolutionfoundation.com.br, e a imagem Docker oficial da versão 2 é a evoapicloud/evolution-api. Se o link acima não abrir diretamente, procure por “evolution-foundation/evolution-api” no GitHub antes de assumir que o projeto foi descontinuado.
O n8n entra como camada de automação visual, e a Groq entra como motor de inteligência artificial, hospedando modelos abertos, como o GPT OSS da OpenAI, em chips próprios (LPU) desenhados para inferência rápida, com um tier gratuito.
Essa combinação não é a escolha certa se sua operação não pode correr nenhum risco de suspensão de número, se você não tem ninguém disposto a fazer manutenção mínima de servidor, ou se você precisa de suporte oficial homologado pela Meta. Nesses casos, um BSP (Business Solution Provider) oficial como a WATI, que cobra uma mensalidade em troca de estabilidade e suporte técnico, é o caminho mais seguro.
Resumo em 10 passos do guia técnico completo abaixo (com todos os comandos, arquivos de configuração e código prontos para copiar):
Visão geral dos 10 passos para montar um chatbot de WhatsApp gratuito com n8n, Evolution API e Groq. O detalhamento técnico completo de cada passo, com todos os comandos, está nas seções abaixo.
Preparar a VPS do zero
Conecte via SSH, atualize o sistema e configure o firewall liberando apenas as portas 22, 80 e 443.
Docker Compose completo, com rede explícita e PostgreSQL
Suba n8n, Evolution API e um banco PostgreSQL dedicado via Docker Compose, numa rede explícita, porque com o SQLite padrão o n8n trava em escritas simultâneas sob carga.
Configurar o Nginx sem conflito de porta
Configure o proxy reverso Nginx para expor n8n e Evolution API sem colisão de portas entre os serviços.
Conectar o WhatsApp na Evolution API
Gere o QR Code pela Evolution API e conecte o número de WhatsApp que vai atender o chatbot.
Instalar o community node da Evolution API no n8n
Adicione o nó comunitário da Evolution API dentro do n8n para receber e enviar mensagens do WhatsApp diretamente nos fluxos.
Montar o fluxo completo
Conecte o gatilho de mensagem recebida, o processamento da resposta e o envio de volta pelo WhatsApp num único fluxo n8n.
Preparar o payload da Groq corretamente (sem erro 400)
Monte a requisição para a API da Groq no formato exato esperado, para evitar o erro 400 comum nesse tipo de integração.
Aplicar a técnica do delay humano (human-like buffering)
Adicione um atraso proposital antes de responder, simulando o tempo de digitação humano, para o chatbot não parecer um robô respondendo instantaneamente.
Testar antes de divulgar o número
Rode uma bateria de testes internos completa antes de divulgar o número do WhatsApp publicamente.
Colocar em produção com segurança
Finalize com as práticas de segurança de credenciais e monitoramento antes de considerar o chatbot pronto para uso real.
Passo 1: Preparar a VPS do Zero
Conecte na sua VPS via SSH:
bash
ssh root@SEU_IP_AQUIAtualize o sistema e instale o essencial:
bash
apt update && apt upgrade -y
apt install -y curl git ufw
Configure o firewall liberando apenas o necessário:
bash
ufw allow 22/tcp
ufw allow 80/tcp
ufw allow 443/tcp
ufw enable
Instale o Docker e o Docker Compose com o script oficial:
bash
curl -fsSL https://get.docker.com -o get-docker.sh
sh get-docker.sh
apt install -y docker-compose-plugin
Confirme a instalação:
bash
docker --version
docker compose version
Se você prefere não lidar com linha de comando além dessa etapa inicial, o EasyPanel é um painel gratuito que se instala sobre o Docker e permite subir os containers seguintes por interface gráfica.
Passo 2: Docker Compose Completo, com Rede Explícita e PostgreSQL
Esse é o ponto onde a maioria dos tutoriais simplificados falha de duas formas ao mesmo tempo. Primeiro: por padrão, o n8n usa SQLite, banco de dados em arquivo único, que trava em escritas concorrentes quando vários workflows disparam ao mesmo tempo, algo comum quando o agente atende várias conversas em paralelo. Segundo: quando as portas do n8n e da Evolution API são publicadas em todas as interfaces do servidor, elas ficam expostas na internet e podem disputar porta com o Nginx. A rede nomeada deixa explícito por onde os containers conversam entre si, e as portas ficam presas ao localhost.
Crie a pasta de projeto e o arquivo .env:
bash
mkdir ~/whatsapp-agent && cd ~/whatsapp-agent
nano .env
Antes de preencher o .env, gere uma chave de criptografia real para o n8n em vez de inventar uma string qualquer:
bash
openssl rand -hex 32Copie o resultado e use como N8N_ENCRYPTION_KEY abaixo. Conteúdo do .env (troque todos os valores de exemplo pelos seus):
env
DOMAIN=seu-dominio.com
EVO_DOMAIN=evo.seu-dominio.com
N8N_ENCRYPTION_KEY=cole_aqui_o_resultado_do_openssl
POSTGRES_USER=n8n
POSTGRES_PASSWORD=troque_por_outra_senha_forte
POSTGRES_DB=n8n
EVOLUTION_API_KEY=gere_uma_chave_aleatoria_longa
GROQ_API_KEY=sua_chave_da_groq_aqui
Agora o docker-compose.yml. A rede nomeada app_network permite que os containers se encontrem pelo nome (o n8n e a Evolution API falam com o postgres e o redis), e as portas do n8n e da Evolution API são publicadas só em localhost, o que elimina o conflito de porta com o Nginx:
yaml
networks:
  app_network:
    driver: bridge

services:
  postgres:
    image: postgres:16-alpine
    restart: always
    networks:
      - app_network
    environment:
      - POSTGRES_USER=${POSTGRES_USER}
      - POSTGRES_PASSWORD=${POSTGRES_PASSWORD}
      - POSTGRES_DB=${POSTGRES_DB}
    volumes:
      - postgres_data:/var/lib/postgresql/data
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U ${POSTGRES_USER}"]
      interval: 10s
      timeout: 5s
      retries: 5

  redis:
    image: redis:7-alpine
    restart: always
    networks:
      - app_network
    volumes:
      - redis_data:/data
    command: redis-server --appendonly yes --maxmemory 256mb --maxmemory-policy allkeys-lru
    healthcheck:
      test: ["CMD", "redis-cli", "ping"]
      interval: 10s
      timeout: 5s
      retries: 5

  n8n:
    image: n8nio/n8n:latest
    restart: always
    networks:
      - app_network
    ports:
      - "127.0.0.1:5678:5678"
    environment:
      - N8N_ENCRYPTION_KEY=${N8N_ENCRYPTION_KEY}
      - WEBHOOK_URL=https://${DOMAIN}/
      - N8N_HOST=${DOMAIN}
      - N8N_PROTOCOL=https
      - DB_TYPE=postgresdb
      - DB_POSTGRESDB_HOST=postgres
      - DB_POSTGRESDB_PORT=5432
      - DB_POSTGRESDB_DATABASE=${POSTGRES_DB}
      - DB_POSTGRESDB_USER=${POSTGRES_USER}
      - DB_POSTGRESDB_PASSWORD=${POSTGRES_PASSWORD}
      - N8N_COMMUNITY_PACKAGES_ENABLED=true
      - GENERIC_TIMEZONE=America/Sao_Paulo
    volumes:
      - n8n_data:/home/node/.n8n
    depends_on:
      postgres:
        condition: service_healthy
      redis:
        condition: service_healthy

  evolution-api:
    # imagem oficial da Evolution API v2; confira a tag mais recente antes de subir
    image: evoapicloud/evolution-api:v2.1.1
    restart: always
    networks:
      - app_network
    ports:
      - "127.0.0.1:8080:8080"
    environment:
      - SERVER_URL=https://${EVO_DOMAIN}
      - AUTHENTICATION_API_KEY=${EVOLUTION_API_KEY}
      - DATABASE_ENABLED=true
      - DATABASE_PROVIDER=postgresql
      - DATABASE_CONNECTION_URI=postgresql://${POSTGRES_USER}:${POSTGRES_PASSWORD}@postgres:5432/${POSTGRES_DB}?schema=evolution_api
      - DATABASE_CONNECTION_CLIENT_NAME=evolution
      - CACHE_REDIS_ENABLED=true
      - CACHE_REDIS_URI=redis://redis:6379/1
      - CACHE_REDIS_PREFIX_KEY=evolution
      - CACHE_LOCAL_ENABLED=false
    volumes:
      - evolution_data:/evolution/instances
    depends_on:
      postgres:
        condition: service_healthy
      redis:
        condition: service_healthy

volumes:
  postgres_data:
  redis_data:
  n8n_data:
  evolution_data:
Note o detalhe que resolve o conflito de porta do Nginx: as portas do n8n e da Evolution API são publicadas apenas em 127.0.0.1 (localhost), não em todas as interfaces. Só o próprio servidor consegue acessá-las diretamente, e é o Nginx, rodando no host, quem expõe cada serviço ao mundo em um subdomínio próprio, ambos na porta 443, sem abrir a porta 8080 para a internet.
A variável que a maioria dos tutoriais simplificados omite: N8N_COMMUNITY_PACKAGES_ENABLED=true. Sem ela, o community node da Evolution API do Passo 5 nem aparece como opção para instalar.
Repare que o docker-compose.yml não usa as antigas variáveis N8N_BASIC_AUTH: elas foram removidas no n8n 1.0 e hoje são ignoradas, segundo a documentação de gestão de usuários do n8n. No primeiro acesso, o n8n pede para criar a conta de proprietário (owner) com e-mail e senha, e é essa conta que protege o painel. Faça isso logo depois de subir os containers. A Evolution API v2 também exige um banco PostgreSQL, por isso ela usa o mesmo servidor Postgres do n8n, num schema separado (evolution_api).
Suba tudo:
bash
docker compose up -d
docker compose ps
Se algum serviço não subir, veja o log específico:
bash
docker compose logs n8n
docker compose logs evolution-api
Passo 3: Configurar o Nginx sem Conflito de Porta
Instale o Nginx e o Certbot fora do Docker, direto no host:
bash
apt install -y nginx certbot python3-certbot-nginxComo o n8n e a Evolution API agora estão publicados só em localhost (Passo 2), o Nginx pode expor cada um em um subdomínio próprio, tudo pela porta 443 padrão, sem abrir uma segunda porta pública. Usar subdomínio, em vez de um caminho como /evolution/, evita que o painel web da Evolution API quebre ao carregar os próprios arquivos:
bash
nano /etc/nginx/sites-available/whatsapp-agentnginx
server {
    listen 80;
    server_name seu-dominio.com;

    location / {
        proxy_pass http://127.0.0.1:5678;
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;
        proxy_http_version 1.1;
        proxy_set_header Upgrade $http_upgrade;
        proxy_set_header Connection "upgrade";
    }
}

server {
    listen 80;
    server_name evo.seu-dominio.com;

    location / {
        proxy_pass http://127.0.0.1:8080;
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;
        proxy_http_version 1.1;
        proxy_set_header Upgrade $http_upgrade;
        proxy_set_header Connection "upgrade";
    }
}
O header Host repassado corretamente em ambos os blocos é o que garante que os webhooks da Evolution API cheguem intactos ao n8n. Se esse header estiver ausente ou errado, a requisição pode ser rejeitada silenciosamente, sem nenhum erro visível no log, e as mensagens simplesmente não chegam.
Ative o site e gere o certificado SSL:
bash
ln -s /etc/nginx/sites-available/whatsapp-agent /etc/nginx/sites-enabled/
nginx -t
systemctl reload nginx
certbot --nginx -d seu-dominio.com -d evo.seu-dominio.com
O Certbot renova o certificado automaticamente a cada 90 dias via um timer próprio. Confirme que está ativo com systemctl status certbot.timer.
Com essa configuração, o n8n fica em https://seu-dominio.com e a Evolution API em https://evo.seu-dominio.com. É esse endereço da Evolution API que você vai usar no painel de administração e nas credenciais do n8n daqui em diante.
Passo 4: Conectar o WhatsApp na Evolution API
Acesse https://evo.seu-dominio.com/manager, autentique com a EVOLUTION_API_KEY definida no .env, crie uma instância e escaneie o QR Code com o número dedicado, em WhatsApp > Configurações > Aparelhos Conectados > Conectar um Aparelho.
Sobre o risco de banimento: a Evolution API não é uma solução oficial da Meta. O risco de suspensão existe e cresce com envio em massa, respostas mais rápidas do que um humano conseguiria digitar, ou uso do número para spam. Configure um pequeno delay entre mensagens automáticas (Passo 8) e use sempre um número dedicado, nunca o pessoal.
Sim, existe risco de banimento, mas ele é gerenciável com boas práticas, e não se agrava por causa do conteúdo ser gerado por IA. Desde 15 de janeiro de 2026, a própria Meta passou a restringir explicitamente assistentes de IA de propósito geral (como ChatGPT ou Perplexity) operando como produto principal dentro do WhatsApp Business, mas manteve permitido o uso de IA para funções definidas, como suporte ao cliente, reservas e rastreamento de pedidos, exatamente o caso de uso deste guia. Isso não muda o risco técnico da conexão via QR Code, que é da Evolution API e não da política da Meta, mas confirma que um chatbot de atendimento com escopo definido continua dentro do uso pretendido pela própria Meta para automação de negócios.
Passo 5: Instalar o Community Node da Evolution API no n8n
Sim, vale instalar o community node em vez de montar tudo com HTTP Request genérico, porque ele já resolve formatação de mensagem, envio de mídia e autenticação, tarefas que, feitas na mão, custam bem mais tempo de configuração do que os dois minutos que leva para instalar o pacote.
Em vez de montar tudo com nodes genéricos de HTTP Request, existe um community node dedicado, o n8n-nodes-evolution-api, mantido pela OrionDesign, que já cobre envio de texto, imagem, áudio, vídeo, listas interativas, botões e mensagens PIX, além de gerenciamento de instâncias e grupos direto na interface do n8n.
Para instalar:
A ilustração abaixo mostra a tela de instalação do community node dentro do n8n. Note que, sem a variável N8N_COMMUNITY_PACKAGES_ENABLED=true configurada no Passo 2, essa opção nem aparece no menu, e é exatamente esse detalhe que faz a maioria dos tutoriais simplificados travar nesse ponto.
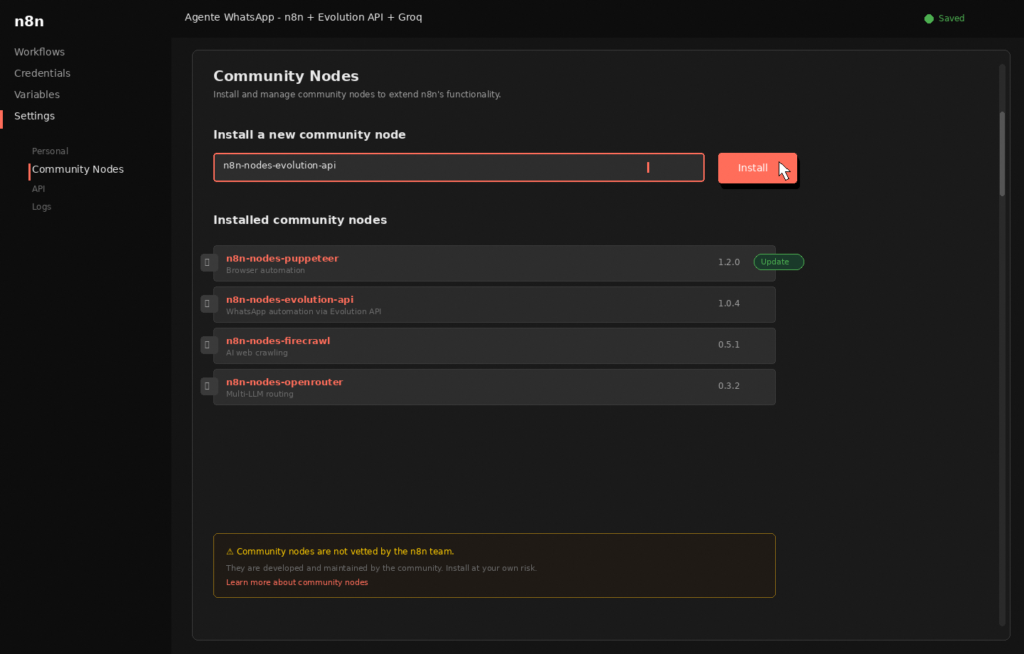
- No n8n, vá em Settings > Community Nodes
- Clique em Install a community node
- Digite
n8n-nodes-evolution-apie confirme
Se a opção não aparecer, confira se N8N_COMMUNITY_PACKAGES_ENABLED=true está mesmo definida no docker-compose.yml e reinicie o container com docker compose restart n8n.
Depois de instalado, crie uma credencial do tipo Evolution API dentro do n8n, apontando para https://evo.seu-dominio.com e usando a EVOLUTION_API_KEY do seu .env.
Um ponto que costuma travar quem está começando: a chave definida em AUTHENTICATION_API_KEY no docker-compose.yml é a chave global, usada para autenticar no painel de administração e criar novas instâncias. Cada instância pode receber, opcionalmente, um token próprio, exibido no painel dela, usado quando você quer isolar permissões por número. Para um único número de atendimento, a chave global é suficiente e é a que a credencial acima deve usar.
Passo 6: Montar o Fluxo Completo
O fluxo completo tem sete nodes na sequência, do webhook até o envio da resposta, e o ponto mais fácil de esquecer é o filtro anti-loop logo depois do webhook; sem ele o agente responde à própria mensagem e pode esgotar o limite diário da Groq em minutos.
A lógica do workflow:
Webhook (Evolution API) leva a um filtro anti-loop, que leva à busca do histórico no Redis, que leva a um node de preparação do payload, que leva à chamada da Groq, que leva ao salvamento do histórico atualizado no Redis, que leva ao envio da resposta pela Evolution API.
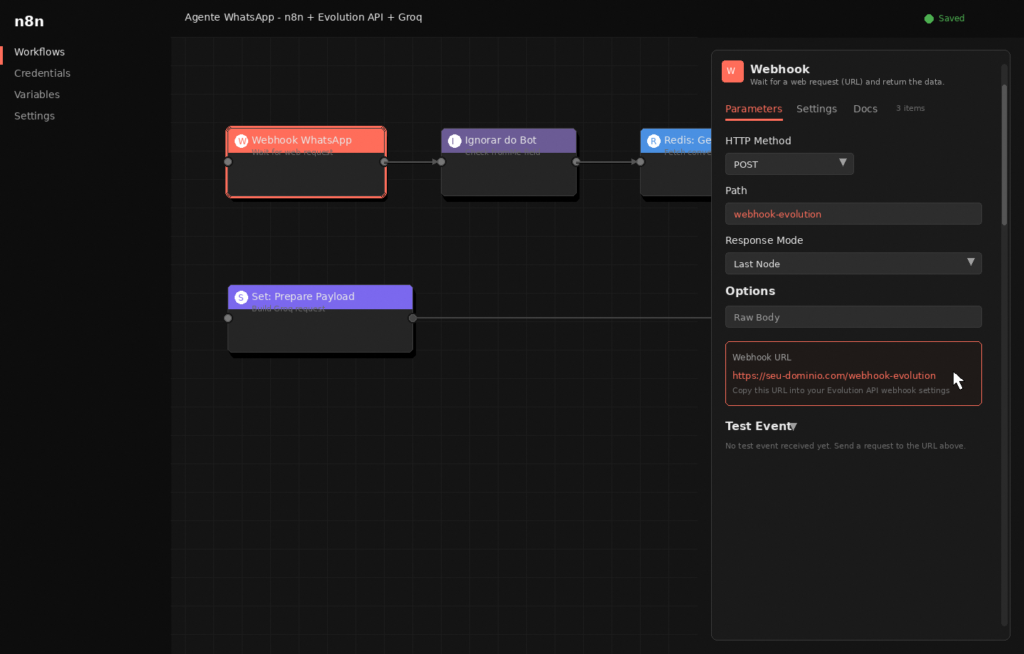
- Webhook: crie um node Webhook e configure essa URL na seção de Webhooks da instância na Evolution API, habilitando o evento
MESSAGES_UPSERT
A ilustração abaixo mostra como o node Webhook fica configurado dentro do n8n. O path definido (webhook-evolution) é combinado com o domínio da VPS para formar a URL completa que será colada nas configurações de webhook da instância Evolution API. O método HTTP deve ser POST, porque a Evolution API envia os dados da mensagem no corpo da requisição.
- Filtro anti-loop: adicione um node IF verificando se
{{$json.data.key.fromMe}}éfalse. Sem esse filtro, o agente responde à própria mensagem e entra em loop, o que pode esgotar seu limite de requisições da Groq em minutos - Buscar histórico: node Redis, operação Get, usando
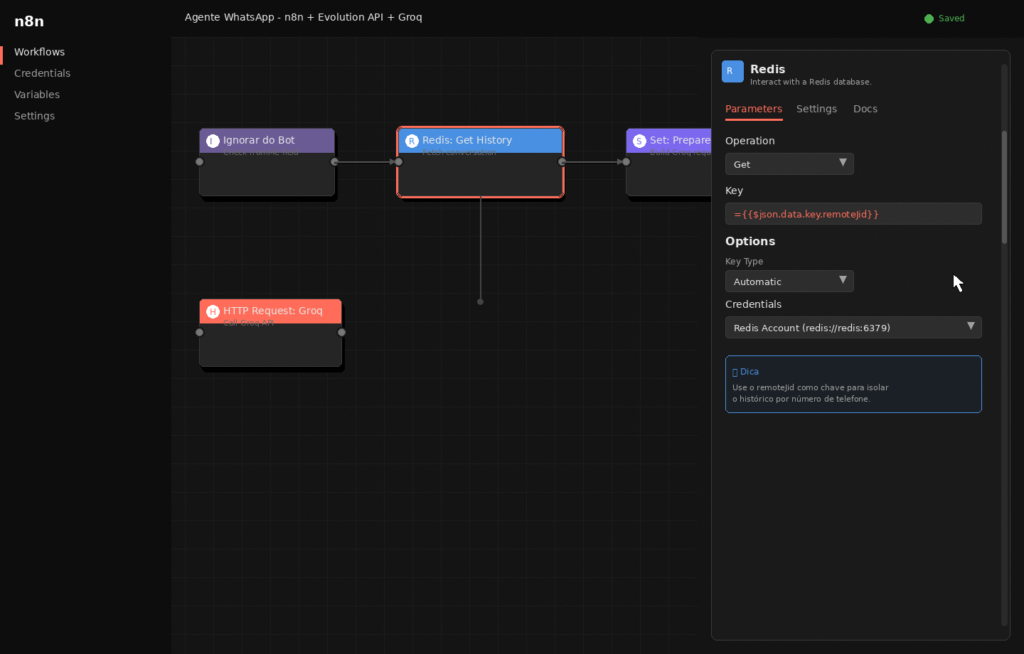
{{$json.data.key.remoteJid}}, o número do cliente, como chave
A ilustração abaixo mostra a configuração do node Redis em modo Get. A chave usada (={{$json.data.key.remoteJid}}) é o número de telefone do cliente completo, com código do país, e isso garante que o histórico de cada conversa fique isolado. Se você usar um ID genérico ou o nome do cliente, conversas de pessoas diferentes podem se misturar, o que é o erro mais silencioso e difícil de detectar nesse tipo de projeto.
- Preparar o payload: veja o Passo 7, é aqui que a maioria dos tutoriais quebra silenciosamente
- Gerar resposta: node HTTP Request apontando para a API da Groq
- Salvar histórico: node Redis, operação Set, mesma chave, TTL de 86400 segundos (24 horas) para atendimento simples ou 604800 (7 dias) para ciclos de venda mais longos
- Enviar resposta: use o node da Evolution API instalado no Passo 5, operação Send Text, em vez de HTTP Request bruto, porque ele já formata a mensagem corretamente
Passo 7: Preparar o Payload da Groq Corretamente (Sem Erro 400)
Este é o passo que a maioria dos tutoriais simplifica de um jeito que não funciona na prática. Escrever expressões n8n (={{ ... }}) direto dentro de um bloco JSON colado manualmente exige ativar o modo de expressão especificamente naquele campo, e um JSON com aspas mal escapadas pelo meio de uma expressão é a causa mais comum de erro 400 nesse tipo de fluxo. A forma confiável de evitar isso é preparar o texto antes, num node separado, e só depois montar a chamada HTTP.
Adicione um node Edit Fields (Set) antes do node HTTP Request, criando dois campos:
system_prompt, com o texto fixo de instrução do agentemensagem_usuario, com a expressão{{ $json.historico }} Cliente: {{ $json.data.message.conversation }}, preenchida no campo próprio do node, onde o n8n já trata a expressão corretamente, sem risco de quebrar o JSON
No node HTTP Request seguinte, configure:
- Método: POST
- URL:
https://api.groq.com/openai/v1/chat/completions - Autenticação: Header Auth, com
Authorization: Bearere suaGROQ_API_KEY - Body: ative Send Body, escolha JSON e Using JSON, e deixe o campo em modo Expression para que o n8n resolva o
JSON.stringify:
json
{
  "model": "openai/gpt-oss-20b",
  "messages": [
    { "role": "system", "content": {{ JSON.stringify($json.system_prompt) }} },
    { "role": "user", "content": {{ JSON.stringify($json.mensagem_usuario) }} }
  ],
  "temperature": 0.6,
  "max_completion_tokens": 800,
  "reasoning_effort": "low"
}
O JSON.stringify faz o trabalho que costuma faltar: ele coloca as aspas e escapa quebras de linha e aspas internas do texto. Sem ele, basta o cliente escrever uma frase com aspas para o corpo virar um JSON inválido e a Groq devolver erro 400. O parâmetro reasoning_effort em low mantém o modelo GPT OSS rápido e econômico para atendimento, e max_completion_tokens limita o tamanho da resposta, incluindo o raciocínio interno do modelo.
Atualização sobre modelos: a Groq desativou o llama-3.1-8b-instant e o llama-3.3-70b-versatile para as contas gratuita e developer em 16 de agosto de 2026, conforme a página oficial de descontinuação de modelos. Por isso o exemplo acima já usa o openai/gpt-oss-20b, indicado pela própria Groq como substituto para respostas rápidas. Para conversas mais complexas, troque por openai/gpt-oss-120b. Os dois têm janela de contexto de 131 mil tokens. Confira a lista de modelos ativos antes de subir, porque o catálogo muda com frequência.
Preços dos modelos indicados para atendimento, conforme a página oficial de modelos da Groq em outubro de 2026:
| Modelo | Preço (entrada/saída por milhão de tokens) | Indicado para |
|---|---|---|
openai/gpt-oss-20b | US$ 0,075 / US$ 0,30 | Respostas rápidas, triagem, FAQ |
openai/gpt-oss-120b | US$ 0,15 / US$ 0,60 | Conversas mais complexas, raciocínio |
Calculadora: Você Vai Estourar o Limite Grátis da Groq no Seu Agente de WhatsApp?
O tier gratuito da Groq não é um teto único, são quatro limites ao mesmo tempo: requisições por minuto, tokens por minuto, requisições por dia e tokens por dia. Seu agente pode estourar qualquer um deles antes dos outros, dependendo do modelo escolhido e do tamanho do histórico de conversa enviado a cada chamada. Simule seu cenário abaixo antes de colocar o agente em produção.
IADOBRASIL, RESULTADO DO SEU CÁLCULO GROQ
──────────────────────────────────────────
──────────────────────────────────────────
Cálculo pronto ✅
Limites do plano gratuito conforme a documentação de rate limits da Groq, em outubro de 2026: openai/gpt-oss-20b e openai/gpt-oss-120b com 30 requisições/min, 1.000 requisições/dia, 8.000 tokens/min e 200.000 tokens/dia. Confirme os valores da sua conta em console.groq.com/settings/limits. O pico assume 25% do volume diário concentrado na hora mais movimentada, uma estimativa de referência, não uma medição do seu tráfego real.
Nos modelos GPT OSS, o plano gratuito da Groq tinha em outubro de 2026 quatro limites simultâneos: 30 requisições por minuto, 1.000 por dia, 8 mil tokens por minuto e 200 mil tokens por dia, segundo a documentação de limites da Groq. Confira os valores da sua conta na Groq Console antes de planejar volume.
Passo 8: A Técnica do Delay Humano (Human-like Buffering)
Um atraso de 2 a 4 segundos antes de enviar a resposta é suficiente na maioria dos casos, tempo curto o bastante para não frustrar o cliente e longo o bastante para não parecer uma resposta instantânea de robô.
Um detalhe que reduz tanto o risco de banimento quanto a sensação de estar falando com um robô: inserir um pequeno atraso proposital antes de enviar a resposta, simulando o tempo que um atendente humano levaria para digitar.
Adicione um node Wait de 2 a 4 segundos entre a geração da resposta (Passo 7) e o envio (Passo 6, item 7). Isso também ajuda a absorver picos: se duas mensagens do mesmo cliente chegarem quase juntas, o pequeno atraso dá tempo do fluxo processar sem sobrepor respostas.
Passo 9: Testar Antes de Divulgar o Número
Não divulgue o número antes de passar pelos quatro testes abaixo, principalmente o de forçar uma falha na Groq, porque é o único jeito de saber, antes de um cliente real esbarrar nisso, se o fluxo cai graciosamente ou simplesmente para de responder.
Antes de qualquer cliente real:
- Envie uma mensagem de teste e confirme que ela aparece em Executions no n8n
- Confirme que a resposta chega de volta no WhatsApp
- Envie uma segunda mensagem relacionada e confirme que o agente lembra do contexto (isso valida o Redis)
- Force uma falha, pausando a chave da Groq por um minuto, e veja se o fluxo cai graciosamente para uma mensagem padrão, em vez de simplesmente não responder
Passo 10: Colocar em Produção com Segurança
Colocar em produção com segurança aqui significa três frentes ao mesmo tempo, backup em três camadas, monitoramento ativo e um aviso de LGPD real na primeira mensagem do fluxo. As três juntas evitam o cenário mais comum de projeto DIY que funciona bem no primeiro mês e falha silenciosamente no segundo.
Backup com três camadas:
- Exporte os workflows do n8n em JSON regularmente, pelo menu de cada workflow (opção Download) ou todos de uma vez com
docker compose exec n8n n8n export:workflow --all --output=/home/node/.n8n/workflows-backup.json - Configure snapshots automáticos da VPS pelo painel do provedor
- Faça backup do volume
postgres_datacom uma ferramenta como oresticourcloneapontando para um armazenamento externo. Um snapshot da VPS sozinho não substitui isso se você quiser restaurar rapidamente só o banco
Monitoramento: o UptimeRobot, no plano gratuito, checa a disponibilidade a cada 5 minutos. Os healthcheck configurados no Passo 2 mostram no docker compose ps quando um serviço fica unhealthy, e o restart: always religa containers que param. Atenção: o Docker sozinho não reinicia um container que travou mas continua rodando; para isso, use um monitor externo ou uma ferramenta como o autoheal.
LGPD, de forma concreta: não basta incluir uma cláusula genérica em algum lugar do site. Coloque um aviso curto na primeira mensagem automática do fluxo, algo como “Este atendimento pode ser realizado por inteligência artificial.
Seus dados são usados apenas para este atendimento”, e defina no seu Aviso de Privacidade por quanto tempo o histórico fica armazenado no Redis antes de expirar. O TTL configurado no Passo 6, item 6, é literalmente essa política em código.
Sobre Segurança das Credenciais
O mínimo aceitável é restringir a permissão do arquivo .env com chmod 600 e nunca versioná-lo em um repositório público; qualquer coisa menos que isso deixa senhas e chaves de API legíveis para qualquer processo ou usuário com acesso ao servidor.
O arquivo .env guarda senhas e chaves em texto simples no servidor, o que é padrão para um projeto desse porte, mas vale dois cuidados mínimos: restrinja a permissão do arquivo com chmod 600 .env, para que só o usuário root consiga lê-lo, e nunca versione esse arquivo num repositório Git público. Para operações maiores, com várias pessoas acessando o servidor, vale considerar uma ferramenta de gerenciamento de segredos dedicada, mas isso foge do escopo de um agente único de atendimento.
Quando migrar para a API oficial da Meta: regra do template e token permanente
Esta stack usa a Evolution API, que não é a API oficial do WhatsApp. Se o projeto crescer e você migrar para a API oficial (WhatsApp Cloud API), duas regras mudam o seu fluxo no n8n e vale conhecê-las antes. O passo a passo completo da API oficial está em WhatsApp Cloud API sem BSP.
A regra do template e o erro 131047
Segundo a lista oficial de códigos de erro da Meta, consultada em 16/11/2026, o erro 131047 significa que passaram mais de 24 horas desde a última resposta da pessoa ao número da empresa, e a orientação é enviar uma mensagem baseada em modelo (template). Na prática, fora dessa janela de 24 horas o fluxo não pode mandar texto livre: precisa usar um template previamente aprovado. Um agente de IA que tenta retomar uma conversa depois desse prazo recebe o erro.
Para evitar o problema no n8n:
- guarde a data e a hora da última mensagem recebida de cada cliente;
- antes de enviar, compare esse horário com o momento atual;
- se passaram mais de 24 horas, use um template aprovado em vez de texto livre;
- trate o 131047 como sinal para trocar o tipo de mensagem, e não como falha de rede.
Token permanente em vez do token temporário
O guia oficial de primeiros passos da Cloud API explica que o token de acesso temporário gerado no painel expira rapidamente e não serve para desenvolvimento, e orienta criar um usuário do sistema para gerar um token permanente. No n8n, guarde esse token em uma credencial e nunca dentro do JSON do fluxo. A lista de erros está na página oficial de códigos de erro do WhatsApp.
Se a sua dúvida é quanto custa rodar um agente com modelo e n8n, a conta está em agente de IA com Gemini no n8n: custo real, que parte de outro modelo e não repete este passo a passo.
Quando o Volume Crescer
Não existe um número mágico de mensagens que uma VPS de 4 GB aguenta, isso depende do tamanho do histórico enviado a cada chamada, da complexidade do prompt e de quantas conversas acontecem simultaneamente, e não há benchmark público que cubra exatamente essa combinação de n8n, Evolution API, PostgreSQL e Redis rodando juntos. Na prática, comece observando o uso de CPU e memória do servidor (docker stats mostra isso em tempo real) à medida que o volume cresce, e trate isso como sinal para migrar, em vez de confiar num número fixo.
Quando os recursos apertarem, os passos seguintes são: aumentar vCPU e RAM da VPS, e migrar o n8n para o modo queue, que separa o processo principal dos workers que executam os fluxos, permitindo escalar horizontalmente.
Se sua necessidade for centralizar o acesso a vários modelos de IA diferentes (não apenas a Groq, mas também OpenAI, Anthropic ou Gemini) através de uma única chave e um único endpoint, por exemplo para comparar qual modelo responde melhor a certos tipos de pergunta, vale conhecer gateways de API como o Zenmux, que unificam múltiplos provedores de IA sob uma interface só.
Isso é uma camada de gerenciamento de modelos de IA, não um substituto para a VPS que hospeda o n8n e a Evolution API, são duas coisas diferentes na sua arquitetura.
Comparativo: Evolution API vs Alternativas
A Evolution API vence em custo e customização, a WATI vence em segurança jurídica e suporte oficial, e a Z-API fica no meio, sem servidor próprio mas também sem homologação da Meta. A tabela abaixo resume os critérios que mais pesam nessa decisão.
| Critério | Evolution API (self-hosted) | Z-API | WATI (BSP oficial) |
|---|---|---|---|
| Custo mensal | Só o da VPS | Mensalidade fixa por número | Mensalidade mais alta, com suporte incluído |
| Oficialidade | Não oficial (via QR Code) | Não oficial (via QR Code) | Oficial, homologado pela Meta |
| Risco de banimento | Existe, baixo com boas práticas | Existe, baixo com boas práticas | Praticamente nulo |
| Customização | Total | Média, depende da plataforma | Baixa, dentro dos limites do BSP |
| Setup técnico | Exige servidor próprio | Mais simples, sem servidor | Mais simples, sem servidor |
| Suporte técnico | Comunidade (GitHub, fóruns) | Suporte da própria Z-API | Suporte oficial dedicado |
Pontos Que Guias Internacionais Sobre Este Stack Costumam Cobrir (e Que Merecem Atenção Aqui)
Os guias internacionais mais completos sobre chatbot de WhatsApp self-hosted com IA costumam ir além do fluxo básico de texto e cobrir quatro áreas que fazem diferença em produção: tratamento de mensagens de mídia, mitigação ativa de banimento, monitoramento contínuo e um plano de migração para a API oficial quando o volume cresce. Os quatro pontos abaixo fecham essas lacunas para este guia.
Mensagens de Mídia: Áudio, Imagem e Documento
O fluxo montado no Passo 6 trata apenas mensagens de texto, via data.message.conversation. Na prática, uma parte relevante dos clientes manda áudio ou foto em vez de digitar. O n8n-nodes-evolution-api instalado no Passo 5 já expõe operações para baixar mídia recebida, e o campo data.message.audioMessage ou data.message.imageMessage substitui conversation no payload recebido pelo webhook quando o cliente manda mídia em vez de texto. Para áudio, a rota mais simples é transcrever com um node de Speech-to-Text antes de repassar o texto para a Groq, já que o endpoint de chat completions usado no Passo 7 não recebe áudio bruto. Para imagem, a Groq oferece modelos com suporte a visão (confira a lista atual em console.groq.com/docs/models), capazes de receber a URL da mídia e responder sobre o conteúdo, útil por exemplo para identificar um produto em uma foto enviada pelo cliente. Ignorar mídia por completo é uma opção válida para um MVP, mas vale adicionar pelo menos uma resposta automática do tipo “recebemos sua mensagem de áudio, mas por enquanto respondemos apenas texto”, em vez de deixar o cliente sem retorno nenhum.
Mitigação Ativa de Banimento, Além do Delay
O delay do Passo 8 reduz o risco, mas não é a única prática recomendada. Guias internacionais sobre conexões não oficiais de WhatsApp costumam recomendar também aquecer o número gradualmente nos primeiros dias, começando com poucas dezenas de mensagens por dia e aumentando aos poucos em vez de disparar volume alto logo no primeiro dia de uso; manter uma proporção saudável entre mensagens recebidas e enviadas, já que um número que só envia mensagens em massa sem receber respostas humanas se parece mais com spam para os sistemas antiabuso; e monitorar o status da conexão pela própria Evolution API, que expõe o estado da instância (conectado, desconectado ou banido) por endpoint, permitindo detectar uma queda de conexão antes que o cliente perceba. Nenhuma dessas práticas elimina o risco por completo, mas juntas reduzem bastante a chance de suspensão em comparação com depender apenas do delay do Passo 8.
Monitoramento Contínuo, Além do Uptime
O UptimeRobot do Passo 10 confirma que o servidor responde, mas não confirma que o chatbot está respondendo corretamente. Vale complementar com um teste sintético diário: um workflow separado no próprio n8n que envia uma mensagem de teste para um número de controle todas as manhãs e verifica se a resposta chega dentro do tempo esperado, alertando por e-mail ou WhatsApp para você mesmo se algo falhar. Também vale acompanhar, mesmo que manualmente uma vez por semana, a aba de Executions do n8n filtrada por erro, para pegar falhas silenciosas antes que um cliente reclame.
Quando Migrar Para a API Oficial da Meta (Cloud API)
Vale considerar a migração para a WhatsApp Cloud API oficial quando o volume diário de mensagens passa a gerar risco financeiro real em caso de suspensão, ou quando o negócio já atende clientes suficientes para justificar o custo por mensagem cobrado pela Meta. A boa notícia, confirmada pela própria atualização de política da Meta de janeiro de 2026, é que um chatbot com função definida de atendimento, como o construído neste guia, já está dentro do uso permitido pela Meta, o que facilita a migração. A lógica de negócio do fluxo n8n, os prompts e o histórico guardado no Redis podem ser praticamente reaproveitados, trocando apenas os nodes de entrada e saída da Evolution API pelos nodes ou chamadas HTTP da Cloud API oficial, que exige verificação de empresa e cobra por mensagem (modelo vigente desde julho de 2025), mas elimina o risco de banimento por completo.
O Licenciamento do n8n Não Muda Para Este Uso
Não, você não precisa de licença paga do n8n para este projeto. O n8n é distribuído sob a Sustainable Use License, que permite uso interno e autogerenciado, como o chatbot de atendimento deste guia, gratuitamente e sem limite de workflows. A licença paga só entra em cena se você quiser revender o próprio n8n como produto para terceiros ou remover a marca n8n da interface, cenários que não se aplicam a quem está montando um agente de atendimento para o próprio negócio.
Erros Mais Comuns (e Como Resolver)
Nginx não sobe, porta em conflito: confirme que o docker-compose.yml publica as portas do n8n e da Evolution API só em 127.0.0.1 (Passo 2), nunca em todas as interfaces, e que o Nginx expõe a Evolution API pelo subdomínio próprio, sem uma segunda porta pública (Passo 3).
Webhook não recebe nada: confira o header Host no Nginx e se o evento MESSAGES_UPSERT está marcado na configuração de webhook da instância.
Agente responde a si mesmo em loop: falta o filtro fromMe = false (Passo 6, item 2).
Erro 400 na chamada da Groq: normalmente é uma expressão n8n mal escapada dentro do JSON bruto. Use o node Set e o JSON.stringify do Passo 7 para preparar o texto antes, em vez de escrever a expressão direto no corpo da requisição.
Community node não aparece para instalar: N8N_COMMUNITY_PACKAGES_ENABLED não está true, ou o container não foi reiniciado depois da mudança.
IA esquece a conversa: a chave usada no Redis não é o número de telefone corretamente formatado, ou o TTL expirou antes do esperado.
Sessão do WhatsApp cai sozinha: comportamento esperado de uma conexão não oficial baseada em QR Code, não um bug do seu setup. Reescanear é a única solução; o monitoramento do Passo 10 ajuda a perceber rápido.
Rate limit da Groq estourado: reduza o tamanho do histórico enviado por mensagem, ou migre para o plano pago se os picos forem previsíveis e recorrentes.
Perguntas Frequentes
É realmente grátis criar um chatbot de WhatsApp com n8n, Evolution API e Groq?
A camada de inteligência artificial pode ficar em zero dólar dentro do tier gratuito da Groq para volumes baixos e médios. O custo fixo obrigatório é a VPS, porque n8n, Evolution API, PostgreSQL e Redis precisam rodar em um servidor ligado 24 horas por dia. Não existe uma versão totalmente gratuita incluindo infraestrutura.
Por que usar PostgreSQL em vez do SQLite padrão do n8n?
O SQLite, banco de dados padrão do n8n, funciona bem em testes, mas trava em escritas concorrentes quando vários workflows disparam ao mesmo tempo, situação comum quando o agente atende várias conversas de WhatsApp em paralelo. O PostgreSQL suporta concorrência real e é a configuração recomendada para qualquer instância de n8n em produção, conforme a própria documentação oficial do n8n.
Por que a Evolution API e o Nginx entram em conflito de porta, e como evitar isso?
Se o docker-compose.yml publica a porta da Evolution API diretamente em todas as interfaces do servidor (8080:8080) e o Nginx tenta escutar nessa mesma porta para fazer proxy reverso, os dois disputam o mesmo recurso do sistema operacional. A forma de evitar isso é publicar as portas dos containers apenas em 127.0.0.1 (Passo 2), deixando o Nginx como único ponto de entrada externo, expondo a Evolution API em um subdomínio próprio, em vez de uma porta separada.
Preciso saber programar para seguir este guia?
O n8n é uma ferramenta visual, sem necessidade de escrever código para montar o fluxo. Mas a configuração inicial do servidor exige linha de comando básica: copiar e colar comandos é suficiente, não é necessário saber programação.
Qual a diferença entre a chave de API global e a chave de API por instância na Evolution API?
A AUTHENTICATION_API_KEY definida no docker-compose.yml é a chave global, usada para autenticar no painel de administração e criar novas instâncias. Cada instância pode receber, opcionalmente, um token próprio para isolar permissões. Para um único número de WhatsApp, a chave global é suficiente e é a que este guia usa em todos os exemplos.
A Evolution API é segura para usar ou meu WhatsApp pode ser banido?
A Evolution API não é um produto oficial da Meta, então existe um risco real, ainda que baixo na prática, de suspensão do número. O risco aumenta com envio em massa e respostas mais rápidas do que um humano conseguiria digitar. Um número dedicado ao atendimento, delays configurados entre mensagens e volume moderado reduzem esse risco de forma significativa.
Groq é confiável para produção, ou é só para testes?
A Groq é uma empresa de infraestrutura de IA com chips próprios (LPU) focados em velocidade de inferência, que hospeda modelos abertos como o GPT OSS da OpenAI. O plano gratuito serve para prototipagem e volumes baixos: em outubro de 2026, os modelos GPT OSS tinham limite de 1.000 requisições e 200 mil tokens por dia, conforme a documentação oficial de limites. Acima disso, o plano Developer cobra por token e libera limites bem maiores. A Groq descontinua modelos com aviso prévio, então vale acompanhar a página de descontinuação de modelos.
Vale a pena usar o community node da Evolution API em vez de HTTP Request direto?
Sim, na maioria dos casos. O n8n-nodes-evolution-api já cobre envio de texto, mídia, listas interativas, botões e mensagens PIX com uma interface pronta dentro do n8n, além de tratar formatação e autenticação automaticamente. Montar tudo isso manualmente com HTTP Request funciona, mas exige reescrever uma lógica que a comunidade já mantém e atualiza.
O que acontece com os dados dos meus clientes nessa configuração?
Como toda a stack roda no seu próprio servidor, você é diretamente responsável pela proteção desses dados conforme a LGPD. Isso inclui avisar os clientes que o atendimento pode envolver inteligência artificial e definir por quanto tempo o histórico fica armazenado no Redis antes de ser descartado automaticamente pelo TTL.
Conclusão
A diferença entre um projeto de teste e um agente de WhatsApp pronto para produção não está na parte visível, o fluxo bonito no n8n, mas nos detalhes que este guia tentou cobrir de forma explícita: PostgreSQL em vez de SQLite, uma rede Docker que evita o conflito de porta entre o Nginx e a Evolution API, um payload preparado corretamente antes de chegar na Groq, e um TTL de Redis que também funciona como sua política de retenção de dados para fins de LGPD.
Essa stack faz sentido para quem já decidiu, como vimos no comparativo de custos do Meta Business Agent, que o volume de mensagens do negócio justifica montar algo próprio, e que vale a pena trocar uma mensalidade fixa por algumas horas de configuração e um mínimo de manutenção contínua.
Para quem prefere não lidar com nenhuma camada técnica e não pode correr risco de suspensão de número, um BSP oficial homologado pela Meta continua sendo o caminho mais previsível, mesmo custando mais por mês.
De qualquer forma, teste com volume baixo antes de divulgar o número para toda a base de clientes, ajuste o prompt de sistema com base nas primeiras conversas reais, e só depois escale. Automatizar um atendimento ruim em produção custa muito mais caro do que os poucos dólares que essa stack economiza por mês.