
Resposta direta: o DeepSeek V4.1 Flash cobra, fora do horário de pico, US$ 0,15 por milhão de tokens de entrada, US$ 0,60 de saída e US$ 0,003 de leitura de cache, ou R$ 0,78, R$ 3,11 e R$ 0,0155 com dólar a R$ 5,00 e IOF de 3,5%. No horário de pico, que coincide com o expediente na China, o preço dobra. Os pesos têm licença MIT, e a nota independente é 32 na versão 5 do índice da Artificial Analysis (era 45 no lançamento), contra 58 do Claude Opus 5.5. O ponto de atenção é a LGPD: segundo análises da política de privacidade, os dados enviados à API direta podem ficar armazenados na China.
Esses quatro números mudam a decisão de quem desenvolve ou vende serviços com IA. O preço é cerca de 30 vezes menor que o do Opus 5.5 por token, mas a nota é menor, o modelo escreve muito mais tokens para raciocinar e uma parte do seu trabalho pode cair, sem você perceber, na tarifa dobrada. Nas páginas em português que abri, não encontrei juntos o horário de pico convertido para Brasília, o preço em reais, o custo por tarefa com cache e a análise da LGPD.
Atualização de 30/10/2026: em 27/10/2026 a Artificial Analysis lançou a versão 5 do seu índice de inteligência, com 60% de testes privados. Nela, o DeepSeek V4.1 Flash 1017 marca 32 (eram 45 na versão anterior, a v4.3.2), o Claude Opus 5.5 marca 58, o Sonnet 5.5 marca 54 e o Muse Wonder marca 43. O custo por tarefa medido do DeepSeek passou de US$ 0,26 para US$ 0,60, e os tokens de saída do índice de 210 para 170 milhões. Entre os modelos com pesos já publicados, o DeepSeek empata no topo com o GLM-5.3, a 32, segundo a Artificial Analysis. O preço por token segue em US$ 0,30 e US$ 1,20 no pico, segundo a página da AA. As correções estão marcadas no texto.
O que este guia traz e não se repete nas páginas que li:
- a tabela de horário de pico convertida para Brasília, dia por dia, e o que isso significa para quem trabalha em horário comercial;
- o preço em reais da API, do cache e da busca, mais uma calculadora de agentes que soma o contexto reenviado a cada chamada e deixa você escolher a parte do uso que cai no pico;
- o que a medição independente mostra (nota 32 na versão 5, 170 milhões de tokens de saída para rodar o índice) e o que só a DeepSeek afirma;
- o passo a passo da API, o que se sabe sobre o Brasil e uma tabela de decisão da LGPD que compara API direta, hospedagem de terceiros e pesos hospedados por você.
Por Equipe IA do Brasil.
Como este guia foi feito: em 27/10/2026 cruzei a página do modelo na Artificial Analysis, a cobertura do TechNode, análises da Atoms, da MetricNexus, da Brain Detox, da OrcaRouter, da Apidog e da eesel, além de textos jurídicos brasileiros sobre a LGPD. Não consegui abrir a documentação oficial da DeepSeek, então os detalhes da API vêm de textos que a reproduzem e coincidem entre si. Não rodei benchmarks por conta própria. Quando um número vem da DeepSeek, eu aviso.
Os valores valem para 27/10/2026. O conteúdo é informativo e não substitui orientação jurídica, contábil ou financeira. Preços, janelas de pico e regras de dados podem mudar, e a DeepSeek ainda não lançou o V4.1 Pro.
Última atualização: 30/10/2026.
O que é o DeepSeek V4.1 Flash e o que a atualização 1017 mudou?
O DeepSeek V4.1 Flash é um modelo de linguagem de pesos abertos da DeepSeek, com API lançada em 10 de setembro de 2026 e uma atualização chamada 1017, de 17 de outubro, que a própria empresa descreve como menor. O alias deepseek-flash hoje aponta para a versão 1017, e os nomes antigos deepseek-v4-flash e deepseek-v4-flash-vision-exp continuam roteando para ela, segundo a Brain Detox e a Atoms.
Na prática, o modelo aceita texto e imagem, responde em texto, tem janela de 1 milhão de tokens e pode gerar até 384 mil tokens por resposta. A arquitetura não mudou na 1017: a Brain Detox informa que o arquivo de configuração é idêntico ao de setembro. O que mudou foi o treinamento, com melhora nos testes de agentes e de programação e menos tokens gastos no raciocínio.
| Item | DeepSeek V4.1 Flash 1017 |
|---|---|
| Lançamento da API | 10 de setembro de 2026 |
| Atualização 1017 | 17 de outubro de 2026, classificada pela DeepSeek como atualização menor |
| Alias atual | deepseek-flash, que aponta para a 1017 |
| Janela de contexto | 1 milhão de tokens |
| Saída máxima | Até 384 mil tokens por resposta |
| Entradas e saída | Entram texto e imagem. Sai texto |
| Licença e pesos | MIT, com pesos no Hugging Face e no ModelScope |
| Limite de requisições simultâneas | 2.500 no deepseek-flash e 500 no deepseek-v4-pro, segundo a Atoms |
| Amostragem recomendada | Temperatura 1,0 e top p 1,0, com max_tokens de 256 mil ou mais |
Qual modelo responde quando você chama o deepseek-v4-pro?
Desde 14 de setembro de 2026, as chamadas ao deepseek-v4-pro são roteadas para o V4.1 Flash e cobradas pela tarifa do Flash, até o V4.1 Pro ser lançado. A virada ocorreu ao meio do dia no horário de Pequim, 04h UTC, segundo o TechNode e a Atoms. Antes do roteamento, a tabela do V4 Pro listava US$ 0,66 de entrada e US$ 1,98 de saída por milhão fora do pico. Contra os US$ 0,15 e US$ 0,60 do Flash, a queda é de cerca de 77% na entrada e 70% na saída.
Isso tem dois efeitos práticos. Se o seu sistema chama deepseek-v4-pro achando que usa o modelo maior, você está usando o Flash. E o preço do Pro pode voltar a subir quando o V4.1 Pro sair, então não projete custos de longo prazo sobre a tarifa atual do alias.
Quantos parâmetros tem o DeepSeek V4.1 Flash?
As fontes divergem, então trate qualquer número como estimativa. A Atoms e a LLM Stats falam em 552 bilhões de parâmetros na espinha dorsal, e a LLM Stats acrescenta 196 bilhões de parâmetros do módulo Engram, para cerca de 763 bilhões no total. A Atoms ainda informa 8 bilhões de parâmetros ativos no preenchimento do contexto e 16 bilhões na geração. A Shattered observa que a DeepSeek não publicou um artigo de arquitetura, então nenhum desses números vem de um documento oficial que eu consiga conferir. O requisito de hardware para hospedar os pesos também não aparece nas fontes que li.
Quanto custa o DeepSeek V4.1 Flash em reais?
Fora do horário de pico, a API cobra US$ 0,15 por milhão de tokens de entrada, US$ 0,60 de saída e US$ 0,003 de leitura de cache, ou R$ 0,78, R$ 3,11 e R$ 0,0155 com dólar a R$ 5,00 e IOF de 3,5%. No pico, os três valores dobram: R$ 1,55, R$ 6,21 e R$ 0,0311. Para converter por conta própria, multiplique o valor em dólar por 5,175.
| Item (por milhão de tokens) | Fora do pico (US$) | Fora do pico (R$) | No pico (US$) | No pico (R$) |
|---|---|---|---|---|
| Entrada sem cache | 0,15 | R$ 0,78 | 0,30 | R$ 1,55 |
| Entrada lida do cache | 0,003 | R$ 0,0155 | 0,006 | R$ 0,0311 |
| Saída (inclui raciocínio) | 0,60 | R$ 3,11 | 1,20 | R$ 6,21 |
Quatro detalhes de cobrança evitam surpresas. O preço não mudou na atualização 1017. Em yuan, o TechNode cita, a partir do portal IT Home, 0,02, 1 e 4 yuans por milhão fora do pico. O raciocínio conta como saída. E a página do modelo na Artificial Analysis exibe US$ 0,30 de entrada e US$ 1,20 de saída, que são os valores do pico: quem lê só essa página pode achar que o modelo custa o dobro do que custa fora do pico.
Também há hospedagem de terceiros, segundo a LLM Stats. A Fireworks lista US$ 0,22 de entrada, US$ 0,007 de cache e US$ 0,66 de saída, enquanto a DeepInfra e a Novita listam US$ 0,30, US$ 0,006 e US$ 1,20. Não verifiquei região de processamento, retenção nem contrato desses provedores, e o preço de um intermediário não vale como o da DeepSeek.
Em que horário de Brasília o preço do DeepSeek dobra?
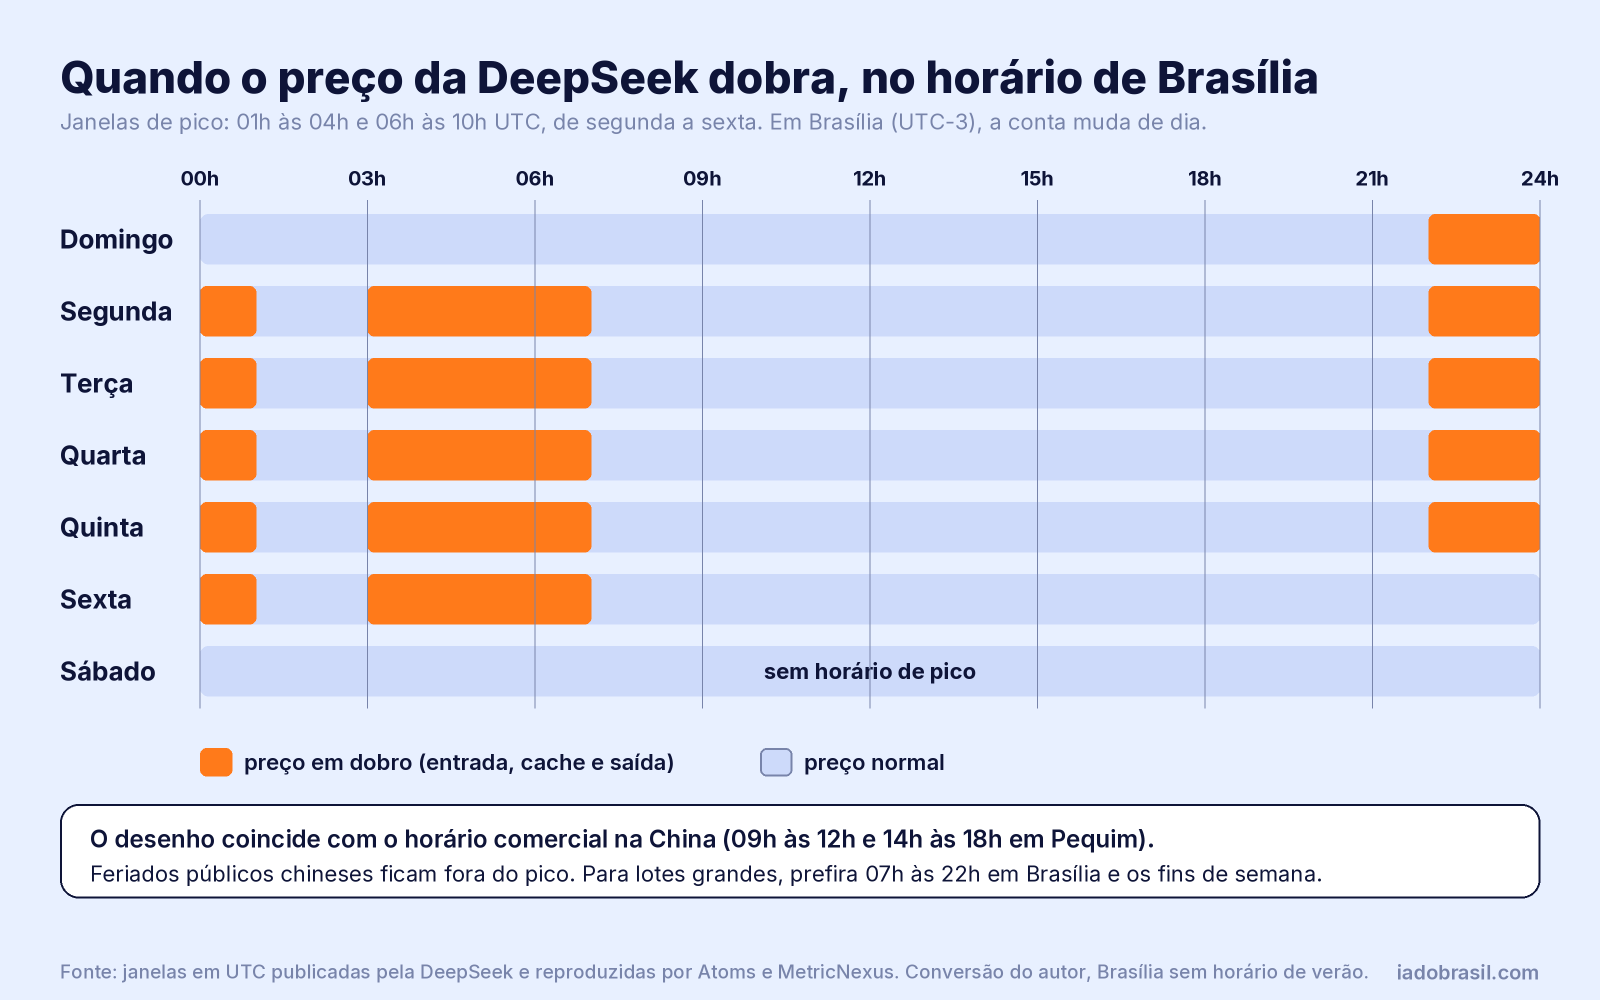
O preço dobra de segunda a sexta, das 01h às 04h e das 06h às 10h UTC, o que corresponde em Brasília (UTC menos 3) às faixas de 00h às 01h, 03h às 07h e 22h às 24h, conforme o dia. Feriados públicos chineses ficam fora do pico, segundo a Atoms. A conversão para Brasília é cálculo meu, sem horário de verão, porque o Brasil não o adota hoje.
| Dia em Brasília | Faixas com preço em dobro |
|---|---|
| Domingo | 22h às 24h |
| Segunda a quinta | 00h às 01h, 03h às 07h e 22h às 24h |
| Sexta | 00h às 01h e 03h às 07h |
| Sábado | Sem horário de pico |
A conclusão útil: o expediente brasileiro, das 09h às 18h, cai por inteiro fora do pico, porque o pico termina às 07h em Brasília e só volta às 22h. O pico bate com o horário comercial chinês (09h às 12h e 14h às 18h em Pequim, outro cálculo meu), e quem roda automações de madrugada no Brasil, entre 03h e 07h, paga o dobro. Um serviço que funciona 24 horas por dia, de forma uniforme, tem cerca de 21% das horas da semana no pico (35 de 168).
Quanto custam a Search API e a Fetch API?
A Search API e a Fetch API custam US$ 0,75 por mil requisições concluídas com sucesso cada, ou R$ 3,88 com a conversão acima. A cobrança começa em 31 de outubro de 2026, às 16h UTC (13h em Brasília), e até lá o uso feito no lado do servidor, pelo DeepSeek Harness, pelo Claude Code ou pelo Codex, é gratuito, segundo a Atoms e o TechNode. Se o seu agente pesquisa muito na web, some esse custo à conta antes de comparar com outros modelos.
Quanto custa uma tarefa de verdade com o DeepSeek V4.1 Flash?
Uma resposta curta custa fração de centavo, a revisão de um contrato de 60 páginas custa cerca de R$ 0,0536 e um agente com 40 chamadas de ferramenta custa R$ 0,40 sem cache e R$ 0,16 com 80% da entrada lida do cache, tudo fora do pico. Usei os mesmos cenários do guia do Muse Wonder, para a comparação ser direta, e refiz as multiplicações com a tabela acima.
| Cenário | Entrada e saída | Fora do pico (US$) | Fora do pico (R$) | No pico (R$) |
|---|---|---|---|---|
| Resposta curta | 2.000 e 800 tokens | 0,00078 | R$ 0,0040 | R$ 0,0081 |
| Revisão de contrato de 60 páginas | 45.000 e 6.000 tokens | 0,01035 | R$ 0,0536 | R$ 0,1071 |
| Agente com 40 chamadas, sem cache | 400.000 acumulados e 30.000 tokens | 0,078 | R$ 0,40 | R$ 0,81 |
| O mesmo agente com 80% da entrada lida do cache | 400.000 acumulados e 30.000 tokens | 0,03096 | R$ 0,16 | R$ 0,32 |
Dois efeitos aparecem. O cache reduz o agente de R$ 0,40 para R$ 0,16, cerca de 2,5 vezes menos, e o pico dobra qualquer linha da tabela. Com os mesmos tokens, o agente de 40 chamadas com cache custa R$ 5,09 no Muse Wonder, ou seja, cerca de 32 vezes mais que no DeepSeek fora do pico.
Esse “mesmos tokens” é a parte enganosa, e a Artificial Analysis mostra o contrapeso. Para rodar o índice com esforço máximo, o DeepSeek V4.1 Flash 1017 gerou 170 milhões de tokens de saída na versão 5 (mediana de 100 milhões entre modelos de pesos abertos de porte semelhante), e o custo por tarefa ficou em US$ 0,60 (R$ 3,11); na versão anterior eram 210 milhões e US$ 0,26 (R$ 1,35). Na versão 5, a mesma AA mede US$ 6,95 (R$ 35,97) para o Muse Wonder e US$ 10,04 (R$ 51,96) para o Opus 5.5. A razão fica em cerca de 12 vezes contra o Muse Wonder e 17 contra o Opus 5.5, menor que a razão de preço por token, porque o DeepSeek gasta mais tokens. As datas e as configurações das medições são diferentes, então leia como ordem de grandeza.

Calculadora do DeepSeek V4.1 Flash: quanto custa um agente por mês
Ao contrário das calculadoras que multiplicam só entrada e saída, esta soma o contexto que o agente reenvia a cada chamada e deixa você escolher duas coisas que só o DeepSeek tem: a parte do uso que cai no horário de pico e a saída extra por o modelo ser mais verboso. Ela calcula a entrada acumulada, a parcela lida do cache e o custo mensal em reais para o DeepSeek, o Claude Sonnet 5.5 e o Claude Opus 5.5, que tem os mesmos preços de tabela do Muse Wonder.
Estimativa mensal em reais, com IOF
Estimativa, não é fatura. Preços por milhão de tokens (entrada, cache lido, saída): DeepSeek V4.1 Flash fora do pico US$ 0,15, 0,003 e 0,60, e no pico US$ 0,30, 0,006 e 1,20; Claude Sonnet 5.5 US$ 2, 0,10 e 10; Claude Opus 5.5 e Muse Wonder US$ 4, 0,20 e 20. Todos os modelos recebem os mesmos tokens, mas cada fornecedor conta tokens de um jeito e usa mais ou menos tokens na mesma tarefa. Na medição da Artificial Analysis (versão 5) o DeepSeek gerou cerca de 1,7 vez a mediana de tokens de saída dos modelos de pesos abertos, então use o campo de saída extra para testar. A gravação de cache dos modelos da Anthropic e da Meta não entra na conta, e busca na web, qualidade da resposta e tentativas repetidas também não.
Com os valores iniciais (1.000 tarefas por mês, 20 chamadas, 8.000 tokens de contexto, 3.000 tokens novos por chamada, 800 de saída e 80% de cache), cada tarefa soma 730 mil tokens de entrada e 16 mil de saída. O DeepSeek fica em cerca de R$ 172,08 por mês fora do pico e R$ 344,16 se todo o uso cair no pico. Sem cache, fora do pico, vai a R$ 616,34. Com os mesmos tokens, o Sonnet 5.5 custaria R$ 2.641,32 e o Opus 5.5, R$ 5.282,64. Se o DeepSeek gastar o dobro de tokens de saída (campo de saída extra em 100%), a conta fora do pico sobe para R$ 221,76, porque a saída passa a pesar quase metade do valor.
Benchmarks do DeepSeek V4.1 Flash: o que é medição independente e o que é da DeepSeek
Na versão 5 do índice da Artificial Analysis (27/10/2026), o DeepSeek V4.1 Flash 1017 marca 32 pontos com esforço máximo, contra 58 do Claude Opus 5.5, 54 do Sonnet 5.5 e 43 do Muse Wonder. No lançamento da 1017, na versão anterior do índice, eram 45, e a versão de setembro aparecia com 39 pontos em uma fonte e com 40 em outra. A queda reflete a nova metodologia, com 60% de testes privados, e atinge os modelos de pesos abertos em geral. Os testes em que o DeepSeek aparece à frente do Opus vêm da tabela da própria DeepSeek, sem reprodução independente.

| Teste | Setembro | 1017 | Claude Opus 5 | Quem está à frente |
|---|---|---|---|---|
| HLE sem ferramentas | 36,8 | 42,6 | 56,3 | Opus |
| Terminal Bench 4.0 | 31,2 | 42,3 | 51,8 | Opus |
| DeepSWE 1.1 | 74,2 | 77,0 | 74,0 | DeepSeek |
| ProgramBench | 20,3 | 29,1 | 37,0 | Opus |
| NL2Repo Bench | 65,4 | 68,2 | 75,3 | Opus |
| Automation Bench | 54,8 | 60,5 | 50,3 | DeepSeek |
| Agents Last Exam | 31,8 | 35,4 | 28,6 | DeepSeek |
| Apex Bench 1.1 | 64,6 | 72,1 | 65,8 | DeepSeek |
| BabyVision | 89,6 | 92,5 | 94,1 | Opus |
Quatro cuidados antes de citar essa tabela. Primeiro, o concorrente é o Claude Opus 5 e não o Opus 5.5, que é mais novo e tem nota 58 no índice independente. Segundo, são resultados da própria DeepSeek, sem reprodução de terceiros que eu tenha encontrado. Terceiro, o ambiente muda o número: a DeepSeek rodou o Terminal Bench 4.0 no Claude Code e o DeepSWE no Mini SWE V2. Quarto, os testes em que o modelo ganha são de agentes e automação, e os que perde são de conhecimento puro (HLE) e programação do zero (ProgramBench, NL2Repo).
Há também um ganho real entre setembro e 1017: o HLE sobe de 36,8 para 42,6, o Terminal Bench de 31,2 para 42,3 e o ProgramBench de 20,3 para 29,1. Na Vals AI, a versão de setembro ficou em 57,86%, na 15ª posição entre 56 modelos e à frente dos pesos abertos, por margem mínima sobre o Kimi K3 (57,81%), segundo a OrcaRouter. Esse resultado é de setembro, e não da 1017.
A atualização 1017 gasta menos tokens e custa menos por tarefa?
Sim: a Sference mediu de 20% a 30% menos tokens de raciocínio para as mesmas respostas, e a eesel leu em um gráfico um custo por tarefa de programação cerca de metade ou menos do de setembro. A Sference, um provedor de inferência, rodou as duas versões nos mesmos problemas, nas mesmas sementes e na mesma infraestrutura, e os números chegam pela MetricNexus e pelo post original da Sference.
| Medida | Setembro | 1017 | Variação |
|---|---|---|---|
| Mediana de tokens de saída no AIME | 1.681 | 1.124 | Menos 33% |
| Mediana de tokens no esforço 1 | 1.974 | 790 | Menos 60% |
| Custo por resposta correta em problemas difíceis (US$) | 0,0037 | 0,0032 | Menos 14% |
| Esforço | Custo por tarefa no DeepSWE, setembro (US$) | Custo por tarefa no DeepSWE, 1017 (US$) |
|---|---|---|
| Baixo | 0,22 | 0,11 |
| Alto | 0,29 | 0,15 |
| Máximo | 0,50 | 0,20 |
A Sference sugere reasoning_effort igual a 25 como padrão para tráfego sensível a custo, e a MetricNexus relata que nesse nível o modelo marcou o máximo em dois conjuntos de matemática por cerca de um quinto a menos que no padrão. Um comentarista da discussão no Hacker News, resumida pelo Zeli em 19/10/2026, disse que em avaliações internas a 1017 gasta menos tokens, mas não pontua mais que a versão anterior. São medições em tarefas específicas, e a sua tarefa pode se comportar de outro jeito. Veja a seção de testes.
O DeepSeek V4.1 Flash alucina e raciocina demais?
Raciocinar demais é a crítica mais repetida, e não encontrei nenhuma medição independente de alucinação do modelo. A página da AA não traz esse dado. Na discussão do Hacker News resumida pelo Zeli, o comentarista Tiberium escreveu que as execuções em esforço máximo gastam muito tempo e muitos tokens por um ganho pequeno, e que o GPT 6.1 Sol em esforço médio sairia mais barato por tarefa (US$ 0,21 contra US$ 0,26, com os valores da versão anterior do índice) e mais rápido (2,9 contra 4,9 minutos). É um comentário de usuário, que não verifiquei. Outro comentarista, lhl, achou a 1017 mais focada e confiável que as versões anteriores.
A eesel dá 4 em 5 para quem constrói produtos e 2 em 5 para atendimento ao cliente e dados sensíveis, e vale lembrar que o autor trabalha na própria eesel. O dado mais sólido de verbosidade é o da AA: na versão 5, 170 milhões de tokens de saída para rodar o índice, contra mediana de 100 milhões entre pesos abertos de porte semelhante (eram 210 milhões contra 140 milhões na versão anterior). Em tarefas com fatos que custam caro se errados, mantenha a revisão humana.
Quão rápido é o DeepSeek V4.1 Flash?
Escreve a cerca de 171 tokens por segundo e começa a responder em 1,17 segundo, segundo a Artificial Analysis com esforço máximo. A versão de setembro aparecia com 175,9 tokens por segundo e 1,23 segundo, segundo o OrcaRouter. Para comparar, o Muse Wonder levou cerca de 31 segundos até o primeiro token no esforço máximo, como mostra o guia do Muse Wonder. A latência inicial baixa não significa resposta rápida: o raciocínio longo antes da resposta final é o que alonga o tempo total, então meça o tempo completo no seu caso.
DeepSeek V4.1 Flash vs Claude Opus 5.5, Sonnet 5.5 e Muse Wonder: qual escolher?
O DeepSeek V4.1 Flash custa cerca de 27 vezes menos que o Claude Opus 5.5 por token de entrada sem cache e 33 vezes menos por token de saída, e tem nota menor no índice independente (32 contra 58 na versão 5). Contra o Sonnet 5.5, é cerca de 13 vezes mais barato na entrada e 17 vezes na saída, com 22 pontos a menos (54 contra 32 na versão 5). O Muse Wonder, com nota 43, tem os mesmos preços do Opus.
| Modelo | Entrada e saída por milhão (US$) | Em reais por milhão | Nota AA v5 | Custo por tarefa na AA v5 (US$) |
|---|---|---|---|---|
| DeepSeek V4.1 Flash 1017 (fora do pico) | 0,15 e 0,60 | R$ 0,78 e R$ 3,11 | 32 | 0,60 |
| Claude Sonnet 5.5 | 2 e 10 | R$ 10,35 e R$ 51,75 | 54 | não verificado na v5 |
| Claude Opus 5.5 | 4 e 20 | R$ 20,70 e R$ 103,50 | 58 | 10,04 |
| Muse Wonder | 4 e 20 | R$ 20,70 e R$ 103,50 | 43 | 6,95 |
Como ler a tabela: o DeepSeek ocupa o lugar de modelo barato e bom o bastante para agentes em volume, e não o de substituto do melhor modelo. Em tarefas em que um erro custa caro, a nota 58 do Opus e a revisão humana contam mais que a economia. Em tarefas em que a taxa de aceitação do DeepSeek ficar próxima da dos modelos caros, a economia de 12 a 17 vezes por tarefa na AA (versão 5, contra o Muse Wonder e o Opus 5.5) vira margem. Quem decide é o seu teste.
Para o duelo de modelos caros, veja Gemini 4 Argon contra Claude Opus 5.5. Para o modelo chinês de preço parecido com o do Sonnet, leia o guia do Kimi K3.1 Pro, e para tarefas simples em volume com a marca Claude, o Claude Haiku 5.5. O panorama geral está em GPT 5.6 contra Claude e Gemini.
Como usar a API do DeepSeek V4.1 Flash passo a passo
Para usar o DeepSeek V4.1 Flash pela API, crie uma chave no painel da DeepSeek, aponte um cliente compatível com a OpenAI para api.deepseek.com, chame o modelo deepseek-flash e acompanhe o uso de cache. Os sete passos abaixo levam cerca de 20 minutos. Os detalhes vêm de textos que reproduzem a documentação, que não consegui abrir, então confirme tudo em documentação oficial da DeepSeek.
Decida entre API, hospedagem de terceiros e pesos próprios
A API da DeepSeek é o caminho mais barato e o mais simples. Hospedagens de terceiros, como as listadas pela LLM Stats, mudam preço e política de dados. Hospedar os pesos MIT você mesmo dá controle total, mas exige infraestrutura de datacenter. A seção sobre a LGPD compara os três, e vale ler essa seção antes de enviar qualquer dado de cliente.
Crie a conta e a chave de API
Crie a chave no painel de desenvolvedores da DeepSeek, indicado na documentação oficial. Não encontrei confirmação de pagamento com cartão brasileiro, crédito grátis ou recarga mínima, então confira a tela de cobrança e lembre do IOF de 3,5% em compras internacionais.
Configure o cliente e o modelo
Use o SDK da OpenAI com a base https://api.deepseek.com e o modelo deepseek-flash. Há também um endpoint compatível com a API da Anthropic em https://api.deepseek.com/anthropic. Guarde a chave em uma variável de ambiente, e não dentro do código.
Escolha o esforço de raciocínio
O cartão do modelo descreve o esforço como uma escala contínua de 1 a 100, segundo a Atoms e a Apidog, e a Apidog avisa que o formato do parâmetro não está confirmado e usa níveis predefinidos no exemplo. A Sference sugere o valor 25 para tráfego sensível a custo. Teste o formato aceito na documentação oficial antes de depender dele.
Acompanhe o cache e o horário de pico
Mantenha o início do prompt idêntico entre as chamadas para que a leitura de cache, a US$ 0,003 por milhão, entre em ação. Registre o uso de cada chamada e marque quais ocorreram nas faixas de pico em Brasília, porque elas custam o dobro. Agende lotes grandes entre 07h e 22h.
Conecte ferramentas de programação, se for o caso
No Claude Code, o endpoint compatível com a Anthropic permite apontar a variável ANTHROPIC_BASE_URL para https://api.deepseek.com/anthropic e informar a chave em ANTHROPIC_AUTH_TOKEN. Teste primeiro em um repositório pequeno e confira se o modelo selecionado é o deepseek-flash.
Proteja os dados e respeite os limites
Troque nomes, CPF e endereços por códigos antes de chamar a API e não envie dados sensíveis. O limite informado é de 2.500 requisições simultâneas no deepseek-flash. Releia a política de privacidade, porque ela prevê treino com dados da API por padrão, com opção de recusa, segundo análises.
O código abaixo mostra o formato de uma chamada com o SDK da OpenAI em Python. Ele usa só parâmetros padrão, sem o campo de esforço, porque o formato desse campo é o ponto sem confirmação.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.deepseek.com",
    api_key=os.environ["DEEPSEEK_API_KEY"],
)

resposta = client.chat.completions.create(
    model="deepseek-flash",
    messages=[
        {"role": "user", "content": "Resuma este texto em cinco pontos e liste os riscos."},
    ],
)

print(resposta.choices[0].message.content)
print(resposta.usage)
Se o seu fluxo roda em n8n, o guia de como criar um agente de IA no WhatsApp com n8n mostra onde o modelo é trocado, e vale testar se o nó aceita a base compatível com a OpenAI. A conta completa de custo por agente está em agente de IA com Gemini e n8n: custo real.
O DeepSeek V4.1 Flash funciona no Brasil?
Nas fontes que li, a API do DeepSeek não tem restrição geográfica declarada para o Brasil, mas também não encontrei confirmação de pagamento com cartão brasileiro, nota fiscal ou cobrança em reais. A conta em reais deste guia é uma conversão do autor, com dólar a R$ 5,00 e IOF de 3,5%.
- API direta: sem restrição de país nas fontes que li. O cadastro e o pagamento dependem das regras da DeepSeek, que não consegui abrir.
- Intermediários: o modelo aparece no OpenRouter e em hospedagens como Fireworks, DeepInfra e Novita, segundo a LLM Stats. Cada intermediário tem preço, política de dados e cobrança próprios.
- Pesos abertos: a licença MIT permite baixar o modelo no Hugging Face e rodar o modelo na sua infraestrutura, o que muda o cenário de dados, mas exige hardware de grande porte.
- Idioma: as fontes que li não trazem avaliação específica em português, e a Artificial Analysis não publica nota por idioma. Rode tarefas reais em português do Brasil antes de decidir.
Para quem trabalha em horário comercial, o preço em dobro raramente atinge o expediente, como a tabela de horários mostrou. Quem automatiza de madrugada ou atende clientes na Ásia pode cair no pico.
Dá para usar o DeepSeek com dados de clientes dentro da LGPD?
Para dados pessoais de brasileiros, a API direta da DeepSeek exige cuidado redobrado: análises da política de privacidade apontam armazenamento na China, treino com dados da API por padrão, com opção de recusa, e nenhuma retenção zero. Enviar dados pessoais para fora do país é transferência internacional, regulada pelos artigos 33 a 36 da Lei 13.709/2018, e exige um mecanismo válido, como cláusulas padrão.
- A eesel avisa que os dados podem ser armazenados na China e que a política lista o treino de modelos com entradas, com opção de recusa.
- A análise de Deepak Gupta, feita a partir da política de privacidade e datada de 08/09/2026, aponta residência de dados na China, treino com dados da API por padrão, prazo de retenção não publicado, ausência de retenção zero, SOC 2 não publicado e ausência de acordo HIPAA. É uma inferência do autor, e não um documento da DeepSeek.
- O escritório Machado Meyer escreveu em 18/02/2025 que o local do agente não é decisivo: o problema é a falta de um mecanismo válido de transferência. Observou também que o aviso de privacidade existia apenas em inglês e em chinês, o que pesa na transparência do artigo 6, inciso VI. O texto é sobre a DeepSeek daquele momento, e a política pode ter mudado.
- Segundo o Migalhas (06/02/2026), o presidente da ANPD, Waldemar Gonçalves, disse que a autoridade pode fiscalizar e sancionar empresas que enviam dados ao exterior sem um mecanismo legal. O prazo para adaptar contratos à Resolução CD/ANPD 19/2024 terminou em agosto de 2025.
| Caminho | Para onde vão os dados | Risco principal na LGPD | Quando faz sentido |
|---|---|---|---|
| API direta da DeepSeek | Segundo análises, processamento e armazenamento na China, com treino por padrão e opção de recusa | Transferência internacional sem decisão de adequação e sem mecanismo comprovado | Dados públicos ou anonimizados, como descrições de produtos, textos de SEO e triagem de conteúdo aberto |
| Hospedagem de terceiros (Fireworks, DeepInfra, Novita, OpenRouter) | Para o provedor escolhido. Região, retenção e contrato não verificados | Depende do contrato e da região do provedor, e há mais um operador na cadeia | Quando o provedor oferece contrato, região e retenção claros, que você deve conferir caso a caso |
| Pesos MIT hospedados por você | Para a sua infraestrutura, no país que você escolher | O risco passa a ser seu: segurança, acesso e retenção | Dados sensíveis ou de clientes, se você tiver infraestrutura de datacenter ou contrato de nuvem |
Sobre o terceiro caminho, o DCD Brasil (03/02/2025) citou o advogado Plastino, do BTLAW, dizendo que uma instância rodada localmente é mais segura, e o advogado Godke apontando que a lei chinesa pode obrigar a divulgação de dados. Os dois comentários eram sobre o DeepSeek R1 e a empresa, e servem aqui como indício, não como regra.
Para dados de saúde, o artigo 5 e o artigo 11 da LGPD tratam como dados pessoais sensíveis, com bases legais mais restritas. Nenhuma capacidade do modelo substitui base legal, minimização e contrato. Se a sua empresa precisa decidir, consulte um advogado de proteção de dados. Para o quadro geral, leia IA gratuita, LGPD e freelancers e Fable 5 e a LGPD, e, se o agente age sozinho em sistemas da empresa, segurança de agentes de IA.
Para quem o DeepSeek V4.1 Flash vale a pena e para quem não vale?
O DeepSeek V4.1 Flash vale mais para agentes em volume, automações com dados públicos e testes que precisam de muitas execuções, e vale menos para dados de clientes, atendimento sem supervisão e tarefas em que um erro custa caro. Os pontos abaixo são hipóteses baseadas em dados públicos, sem promessa de resultado.
Agentes e automações em volume
É onde o preço pesa mais. O agente de 40 chamadas com cache custa R$ 0,16 fora do pico, e a tabela da própria DeepSeek mostra o modelo à frente do Opus 5 em Automation Bench, Agents Last Exam e Apex Bench, testes de agentes. Com mil tarefas por mês, a conta do cenário padrão da calculadora fica em R$ 172,08, contra R$ 5.282,64 com o Opus 5.5. Os números de teste são da DeepSeek, então rode o seu fluxo.
Agências e freelancers: como cobrar por tarefa
O preço mínimo por tarefa é (custo da API mais custo da revisão humana) dividido por (1 menos impostos menos margem). Exemplo ilustrativo com o agente de 40 chamadas e cache de 80%: API de R$ 0,16, seis minutos de revisão a R$ 60 por hora (R$ 6,00), impostos de 6% e margem de 30% dão (0,16 + 6,00) ÷ 0,64 = R$ 9,63 por tarefa. Com o Opus 5.5 ou o Muse Wonder, a API sozinha pesa R$ 5,09, e a conta vira (5,09 + 6,00) ÷ 0,64 = R$ 17,33. A revisão humana, de R$ 6,00, domina o preço no caso do DeepSeek, e por isso a taxa de retrabalho é o que decide a margem. Os percentuais variam com o seu regime tributário, e o exemplo não promete resultado.
A estrutura de preços e o roteiro de prospecção completo estão no guia do Claude Haiku 5.5, e a lógica vale para qualquer modelo. Aqui vale só uma regra: nunca prometa à empresa cliente que o dado fica no Brasil se o fluxo passa pela API direta da DeepSeek.
Quando não usar o DeepSeek V4.1 Flash
Evite o DeepSeek na API direta com dados pessoais ou sensíveis, em atendimento ao cliente sem supervisão (a eesel dá 2 em 5 para esse uso), em tarefas em que a nota 58 do Opus justifica o preço, e quando você não tem como medir a taxa de tarefas aceitas. Também evite confiar na tarifa atual do alias deepseek-v4-pro, que pode mudar quando o V4.1 Pro sair.
Como testar o DeepSeek V4.1 Flash antes de migrar um fluxo?
Separe 20 tarefas reais em português, rode cada uma no pico e fora do pico, nos esforços baixo e alto, e compare o custo por tarefa aceita, e não o preço de tabela. O roteiro é este:
- Escolha 20 tarefas reais com dados já anonimizados e defina antes o que conta como resposta aceita.
- Rode cada tarefa com o esforço no padrão e com o valor 25 sugerido pela Sference, e compare qualidade e tokens de saída.
- Meça a verbosidade: some os tokens de saída por tarefa e compare com o Sonnet 5.5 no mesmo prompt.
- Marque a hora de cada chamada e calcule quanto do volume real cai nas faixas de pico em Brasília.
- Registre a taxa de acerto de cache, porque ela pode mudar o custo por um fator de 2,5 ou mais.
- Calcule o custo por tarefa aceita: custo total das tentativas dividido pelas tarefas aprovadas, incluindo a revisão humana.
- Repita o teste a cada nova versão (1017 hoje, o V4.1 Pro depois), porque o alias pode apontar para outro modelo.
Quais erros custam mais caro ao adotar o DeepSeek V4.1 Flash?
O erro mais caro é enviar dados de clientes pela API direta sem avaliar a LGPD, mas há outros seis:
- Enviar dados pessoais sem mecanismo de transferência. É o risco com maior consequência e o mais fácil de evitar com anonimização.
- Ler o preço do pico como o preço padrão. A página da AA exibe US$ 0,30 e US$ 1,20, que são o dobro do preço fora do pico.
- Rodar lotes de madrugada em Brasília. Entre 03h e 07h, de segunda a sexta, o preço dobra.
- Achar que
deepseek-v4-proé o modelo maior. Desde 14/09/2026, ele é roteado para o Flash. - Deixar o esforço no máximo por padrão. O modelo gerou 170 milhões de tokens para o índice na versão 5 (eram 210 milhões na anterior), e o raciocínio é cobrado como saída.
- Esquecer a cobrança da busca. A Search API e a Fetch API passam a custar US$ 0,75 por mil requisições a partir de 31/10/2026.
- Citar os benchmarks da DeepSeek como independentes. A comparação é com o Opus 5, e a nota independente é 32 contra 58 do Opus 5.5 na versão 5.
Perguntas frequentes sobre o DeepSeek V4.1 Flash: preço, pico, LGPD e Brasil
O DeepSeek V4.1 Flash é gratuito?
Os pesos são gratuitos sob a licença MIT, e quem os hospeda paga a própria infraestrutura. A API é paga: fora do pico custa US$ 0,15 por milhão de tokens de entrada, US$ 0,60 de saída e US$ 0,003 de cache. Não encontrei crédito grátis nas fontes que li.
O DeepSeek V4.1 Flash é open source?
É de pesos abertos: a licença MIT permite baixar, usar e modificar o modelo, e os pesos estão no Hugging Face e no ModelScope. A Shattered observa que a DeepSeek não publicou um artigo de arquitetura, então o código de treino e os dados não são abertos.
Qual é a diferença entre o V4.1 Flash e a versão 1017?
A 1017 é uma atualização menor de 17 de outubro de 2026, com a mesma arquitetura e o mesmo preço. Segundo a DeepSeek, melhora os testes de agentes e programação, e testes independentes mostram de 20% a 30% menos tokens de raciocínio. O alias deepseek-flash aponta para ela.
O DeepSeek V4.1 Pro já existe?
Não até 27/10/2026, nas fontes que li. Desde 14 de setembro, as chamadas ao deepseek-v4-pro são roteadas para o V4.1 Flash e cobradas pela tarifa do Flash, até o V4.1 Pro ser lançado.
Qual é o horário de pico do DeepSeek em Brasília?
De segunda a sexta, o preço dobra em Brasília das 00h às 01h, das 03h às 07h e das 22h às 24h, de segunda a quinta, e só nas duas primeiras faixas na sexta. Domingo tem pico das 22h às 24h, e sábado não tem. A conversão parte das janelas em UTC, 01h às 04h e 06h às 10h.
O DeepSeek V4.1 Flash entende português?
As fontes que li não trazem avaliação específica em português, e a Artificial Analysis não publica nota por idioma. O modelo recebe texto e imagem. Teste 20 tarefas reais em português do Brasil antes de contar com ele.
Posso usar o DeepSeek V4.1 Flash no Claude Code?
Segundo as fontes que reproduzem a documentação, sim: a API tem um endpoint compatível com a Anthropic em https://api.deepseek.com/anthropic, e basta apontar a variável ANTHROPIC_BASE_URL para ele, usar ANTHROPIC_AUTH_TOKEN para a chave e informar o modelo deepseek-flash. Confirme na documentação oficial.
Qual é o tamanho do contexto do DeepSeek V4.1 Flash?
A janela é de 1 milhão de tokens, e a saída máxima é de 384 mil tokens por resposta. Entram texto e imagem, e a resposta sai em texto. Contexto grande custa entrada, então use o cache para evitar pagar o preço cheio a cada chamada.
O DeepSeek usa meus dados para treinar?
Segundo análises da política de privacidade, a DeepSeek treina modelos com dados da API por padrão, com opção de recusa, e não oferece retenção zero. A política pode mudar, então leia a versão atual antes de enviar dados e anonimize o que for pessoal.
O DeepSeek V4.1 Flash é melhor que o Claude Opus 5.5?
Não no índice independente: a Artificial Analysis dá 32 ao DeepSeek e 58 ao Opus 5.5 na versão 5. Em compensação, o custo por tarefa na AA é de US$ 0,60 contra US$ 10,04 do Opus 5.5. Para tarefas em volume com revisão, a economia pode compensar a nota menor.
Conclusão: para quem o DeepSeek V4.1 Flash vale a pena em 2026
O DeepSeek V4.1 Flash vale a pena para quem faz agentes e automações em volume com dados que podem sair do país, aproveita o cache, evita o horário de pico e mede o custo por tarefa aceita. Não vale como escolha automática: a nota independente é 32 contra 58 do Opus 5.5 na versão 5 (era 45 no lançamento), o modelo é verboso, a política de dados da API direta pede cautela e a tarifa do alias pode mudar com o V4.1 Pro.
Os números que sustentam a decisão: R$ 0,78, R$ 3,11 e R$ 0,0155 por milhão fora do pico, o dobro no pico, janela de 1 milhão de tokens, nota 32 na versão 5 (era 45), 170 milhões de tokens de saída para rodar o índice e custo por tarefa de US$ 0,60 na versão 5 (era US$ 0,26). Os benchmarks em que o DeepSeek vence vêm da própria empresa e comparam com o Opus 5, e não com o Opus 5.5.
O caminho mais seguro: use a calculadora com o seu fluxo, teste 20 tarefas reais no DeepSeek, no Sonnet 5.5 e no Opus 5.5, registre cache, pico e tokens de saída e só então decida. Para dados de clientes, trate a API direta como transferência internacional e considere a hospedagem dos pesos ou um provedor com contrato claro.
Vou atualizar este guia quando o V4.1 Pro for lançado, quando a documentação oficial confirmar o formato do esforço de raciocínio e quando houver mudança de preço ou de janela de pico. Se você ainda compara opções, leia também os guias do Muse Wonder, do Kimi K3.1 Pro e do Claude Haiku 5.5.
Fontes consultadas
- Artificial Analysis: DeepSeek V4.1 Flash 1017
- Atoms: DeepSeek V4.1 Flash
- TechNode: DeepSeek lança o V4.1 Flash e roteia o V4 Pro
- Brain Detox: atualização 1017 do V4.1 Flash
- MetricNexus: benchmarks e preço da 1017
- Sference: benchmark da 1017
- OrcaRouter: posição da 1017 na Artificial Analysis
- LLM Stats: DeepSeek V4.1 Flash
- Shattered: corte de preço do V4.1 Flash
- eesel: análise do DeepSeek V4.1 Flash 1017
- Apidog: como usar a API do DeepSeek V4.1 Flash
- Deepak Gupta: DeepSeek V4.1 Flash
- Zeli: resumo da discussão no Hacker News
- Machado Meyer: o DeepSeek está em conformidade com a LGPD?
- DCD Brasil: DeepSeek e a LGPD
- Migalhas: envio de dados ao exterior e a ANPD
- Hugging Face: DeepSeek V4.1 Flash 1017
- Documentação da DeepSeek API
- Preços da Claude API (Anthropic)
- Lei 13.709/2018 (Planalto)